导读:Apache Doris 5.0 增量计算预告(2)|CDC 技术解析篇:上一篇从场景出发,介绍了 Doris 5.0 增量计算的整体能力;这一篇聚焦 Changelog,介绍如何将 Doris 中的数据变化传递至下游。Doris 5.0 在写入时把每一行的变化记录为 Changelog,下游既可以逐条消费变化,也可以只获取净变化;在它之上,IVM 和 Table Stream 在库内加工变化,Flink Doris Connector 再将变化并行、可恢复地传递至下游。本文先解析 Changelog 的读取方式和实现原理,再介绍 Connector 的工作方式,最后结合两个业务场景,介绍怎样在库内加工变化并送到下游。
作者|陈明雨,Apache Doris PMC Chair
在实时数仓里,Doris 长期是链路的终点:业务库的变化经 Flink CDC、Routine Load、Stream Load 流入 Doris,被加工成指标和宽表,供报表和应用查询,链路到此结束。
现在,越来越多的业务把 Doris 当作高性能的计算引擎来用:数据实时写入 Doris,由 Doris 完成关联、聚合和清洗,再把加工好的结果写入其他系统。比如,广告平台在 Doris 里实时汇总每个广告计划的消耗,推给投放系统控制预算;电商平台把多条链路同步来的商品数据合并在 Doris 里,再把最新价格同步给搜索引擎;数据团队把宽表和指标同步给其他团队的业务系统和数据湖。在这些链路里,Doris 是中间的计算节点,下游需要及时、准确地知道 Doris 里的结果变了什么。
过去,这类操作只能通过以下方式进行:
定时全量导出再比对,延迟高、成本高;
按
update_time字段增量导出,看不到删除;把加工逻辑搬到 Flink 里再算一遍,同一套逻辑就要在两个系统里各维护一份。
Doris 5.0 将为自身存储格式引入 Changelog,在写入时把每一次新增、更新和删除,连同更新前后的值一起记录下来,并提供丰富的接口,供进一步处理或下游消费。
在上一篇《从实时入库到实时可用:Apache Doris 5.0 增量计算场景与实践》中,我们已经介绍了基于 Changelog 的各类应用场景。本文将进一步深入探索 Changelog 的实现细节、技术方案,并结合具体场景说明基于这套新的计算框架可以带来哪些业务收益。
一、Changelog 原理解析:在分布式列存里记录变化
MySQL 这类单机系统的 binlog 是一台机器上按提交顺序追加的一份日志;而 Doris 是分布式系统,数据分散在多台机器的多个数据分片上,每个分片还有多个副本,写入吞吐也很高。因此,在 Doris 中实现 Changelog 面临以下挑战:
Changelog 如何和数据保持一致;
如何在分布式系统中保持数据变化的时序;
如何高效地记录和访问 Changelog。
下面先看 Changelog 的三种读取方式,再看它的实现怎样回答这三个问题。
1.1 三种读取方式:DETAIL、MIN_DELTA 与 APPEND_ONLY
建表时打开 Changelog(表属性 changelog.enable),该表后续的新增、更新和删除,都会记录在 Changelog 中。明细表(Duplicate Key 模型)和主键表(Unique Key 模型的 Merge-on-Write 表)都可以开启。主键表还可以打开 before 镜像(changelog.need_historical_value),让每次更新都带上旧值,读取结果对应 Flink 变更流中的一对 -U 和 +U。读取时,在表名后加上 @incr,指定起止时间和读取方式,即可像查询普通表一样获取该时间范围内的变化。读取方式有三种,分别面向不同的下游。
下面以一张开启了 before 镜像的订单表为例,假设 10:00 到 10:05 之间:
订单 1000 在 10:00 之前已经发货,这段时间里买家确认签收;
订单 1001 是新订单,下单后完成了支付;
订单 1002 是重复提交的订单,写入后又被删除。
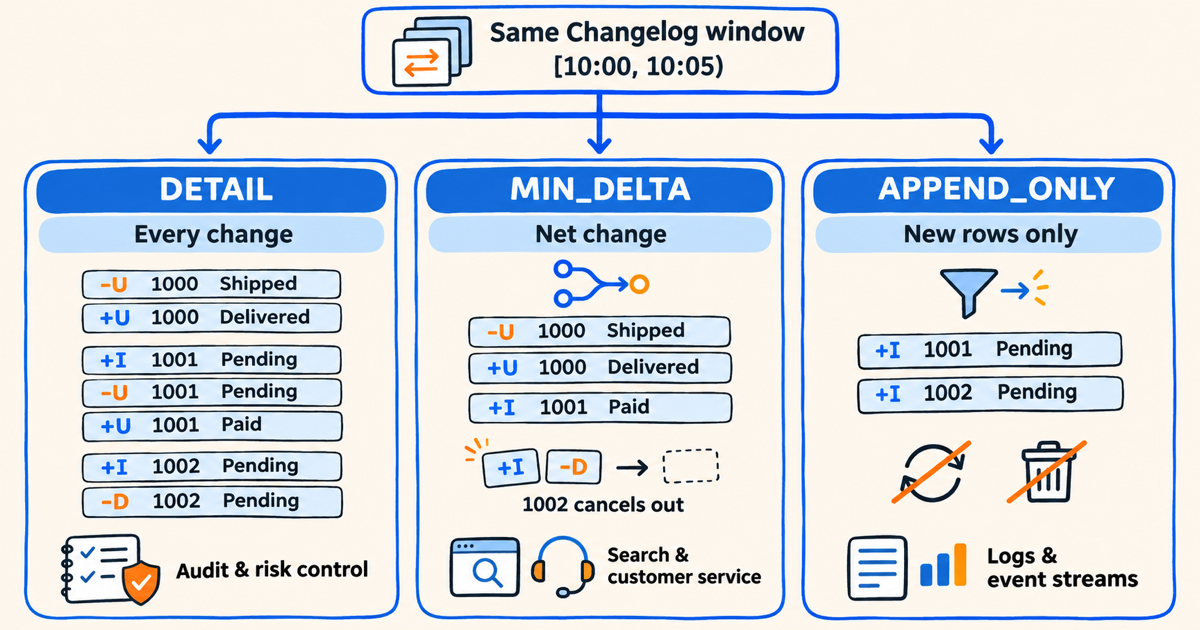
图 1:同一时间范围内,DETAIL 保留每一次变化,适合审计与风控;MIN_DELTA 合并净变化,适合同步搜索索引和客服系统;APPEND_ONLY 只保留新增时的行,适合日志与事件流。
DETAIL:保留每一次变化
审计、风控和订单流转分析,要知道订单经过了哪些状态、每一步发生在什么时候,就需要逐条拿到每一次变化。用 DETAIL 读取这段时间:
SELECT __DORIS_CHANGELOG_OP__ AS op, order_id, status
FROM orders@incr(
    'startTimestamp' = '2026-11-11 10:00:00',
    'endTimestamp'   = '2026-11-11 10:05:00',
    'incrementType'  = 'DETAIL'
);
查询结果包含全部 7 条记录,同一个订单的变化按发生的先后排列:
| op | 订单号 | 状态 |
|---|---|---|
| -U | 1000 | 已发货 |
| +U | 1000 | 已签收 |
| +I | 1001 | 待支付 |
| -U | 1001 | 待支付 |
| +U | 1001 | 已支付 |
| +I | 1002 | 待支付 |
| -D | 1002 | 待支付 |
op 列在查询结果里是数字:0 是新增(+I),1 是删除(-D),2 和 3 是一次更新前后的值(-U 和 +U)。本文的表格里直接写成括号里的符号。
MIN_DELTA:只取净变化
某些下游只关心数据的最终状态,不关心中间变化。比如把订单同步给客服系统或搜索引擎时,订单 1001 中途的“待支付”没有意义;订单 1002 写入后又被删除,对下游而言不存在净变化。把 incrementType 换成 MIN_DELTA,同一个主键在这段时间里的多次变化会合并成一次净变化,前面示例中的 7 条记录只剩 3 条:
| op | 订单号 | 状态 |
|---|---|---|
| -U | 1000 | 已发货 |
| +U | 1000 | 已签收 |
| +I | 1001 | 已支付 |
订单 1000 在这段时间开始前就存在,净变化是一次更新;
订单 1001 开始前还不存在,净变化是新增一条“已支付”;
订单 1002 前后都不存在,没有输出。
MIN_DELTA 模式下,合并在 Doris 里完成,使得下游不必再处理大量中间状态和无效更新。
注意:MIN_DELTA 要用到更新前的值,所以要求主键表开启 before 镜像(原理见 1.5)。
APPEND_ONLY:只看新增
日志、埋点这类只追加的数据,或者下游只关心出现了哪些新记录、不关心之后的修改和删除时,把 incrementType 换成 APPEND_ONLY,只读新增的行:
| op | 订单号 | 状态 |
|---|---|---|
| +I | 1001 | 待支付 |
| +I | 1002 | 待支付 |
订单 1000 只有更新,没有输出;
订单 1002 后来虽然被删除,新增的这一条照样输出。
以上三种方式的输出差别仅针对主键表。明细表因为只有新增,三种方式读出的结果相同。
1.2 Changelog 的生成逻辑
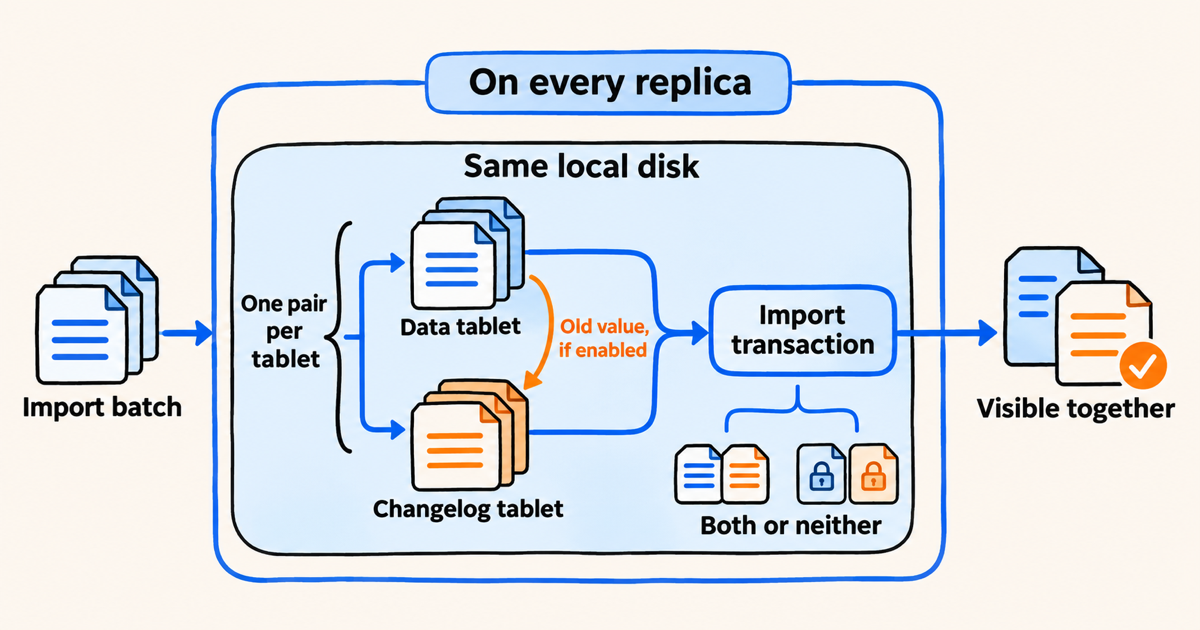
图 2:每个副本上的数据分片与 Changelog 分片位于同一块本地磁盘,数据文件和变化记录通过导入事务一起生效。
Changelog 伴生分片:每个数据分片都配有一个 Changelog 分片(图 2)。数据写入时,Doris 在每个副本上同时写出两份文件,一份是数据,一份是变化记录;需要旧值时,就在本地查出这一行原来的值。通过导入事务机制,两份文件一起生效:数据与变化记录要么同时可见,要么同时不可见,不会出现“数据写进去了,变化没记下来”。
按导入批次聚合:主键表按“每次导入、每个主键”记录变化,同一次导入里对同一个主键写了多次,只记最终结果;明细表则每一行都记录。
并发写入的处理:多个导入同时修改同一个主键时,先查到的旧值可能已经过时。Changelog 的写入,复用了主键表原有的处理写入冲突的机制:提交时发现冲突,就按最新的版本修正受影响的记录,确保记录的旧值对应这一行实际的上一版本。
注意:整体替换数据的操作不逐行记录。TRUNCATE、删除分区、替换分区、INSERT OVERWRITE 这类操作,不会逐行记录删除操作。执行之后,依赖这张表的物化视图需要重建,要和这张表保持一致的下游也需要重新同步一次全量数据;只读取新增数据的消费不受影响(比如 3.1 的 Table Stream 做法)。
1.3 Changelog 的时序:全局时间戳 TSO 和 LSN
Doris 原有的数据版本号由每个分区各自递增,不同分区、不同表之间无法比较先后。要按时间范围读取变化,就需要一个全局统一的时钟,这就是 TSO(Timestamp Oracle,全局时间戳)。
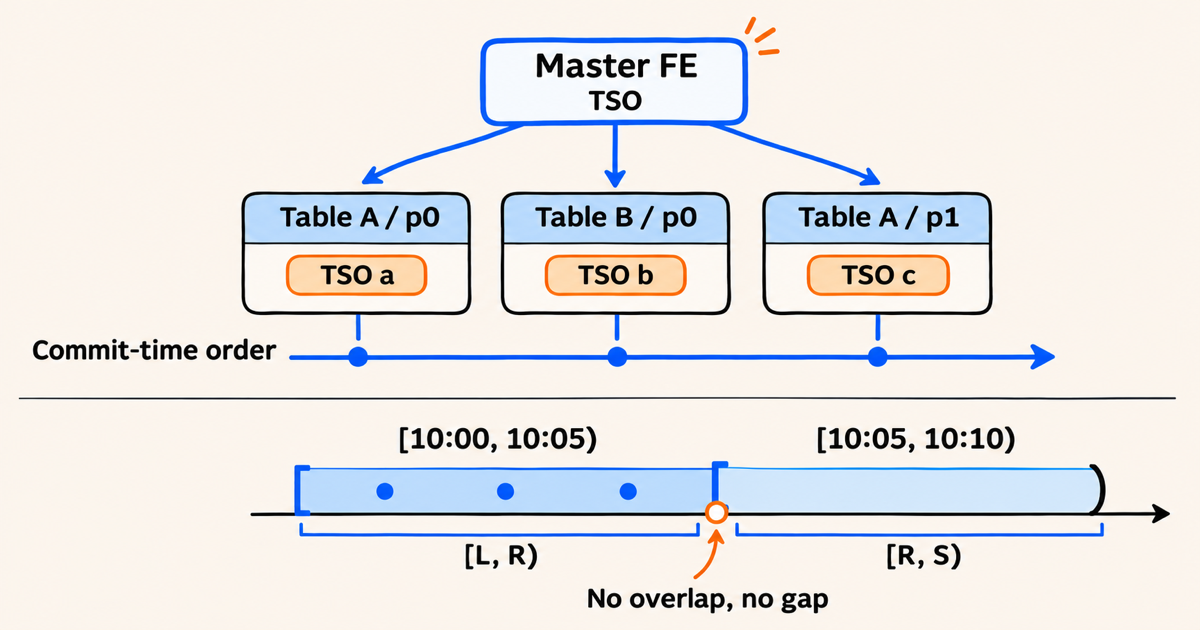
图 3:Master FE 在事务提交时统一分配递增 TSO。时间范围映射为首尾相接的 TSO 区间,用于完整地选取变化。
统一发放,只增不减:TSO 由 Master FE 统一发放(图 3),高位是毫秒级的物理时间,低位是同一毫秒内的计数。即使切换 Master 或者机器时钟回拨,TSO 也不会倒退。高位就是物理时间,所以“10:00 到 10:05”这样的时间范围可以直接换算成 TSO 范围,相邻的时间范围首尾相接,既不重叠,也不遗漏。
TSO 分配机制:一个事务一个 TSO,并且在事务提交时才分配。因为如果按事务开始的时间编号,长事务就会“落回过去”:一个 10:00 开始、10:30 才提交的导入,变化却记在 10:00,而下游早已读过 10:00 那一段,这批变化会被遗漏。
读取前先等待:事务拿到 TSO 后,数据还要过一小段时间才能读到(等待数据 Publish)。如果读 [10:00, 10:05) 时,一个 10:04 提交的事务还没生效,这次就读不到它;下次从 10:05 开始读,又会因为它的 TSO 早于 10:05 而跳过它,这批变化就永远漏掉了(图 4)。所以 Doris 在读取前会先等待,等时间范围内已提交的事务全部生效后再读;等待超时就报错,由下游重试同一个时间范围。
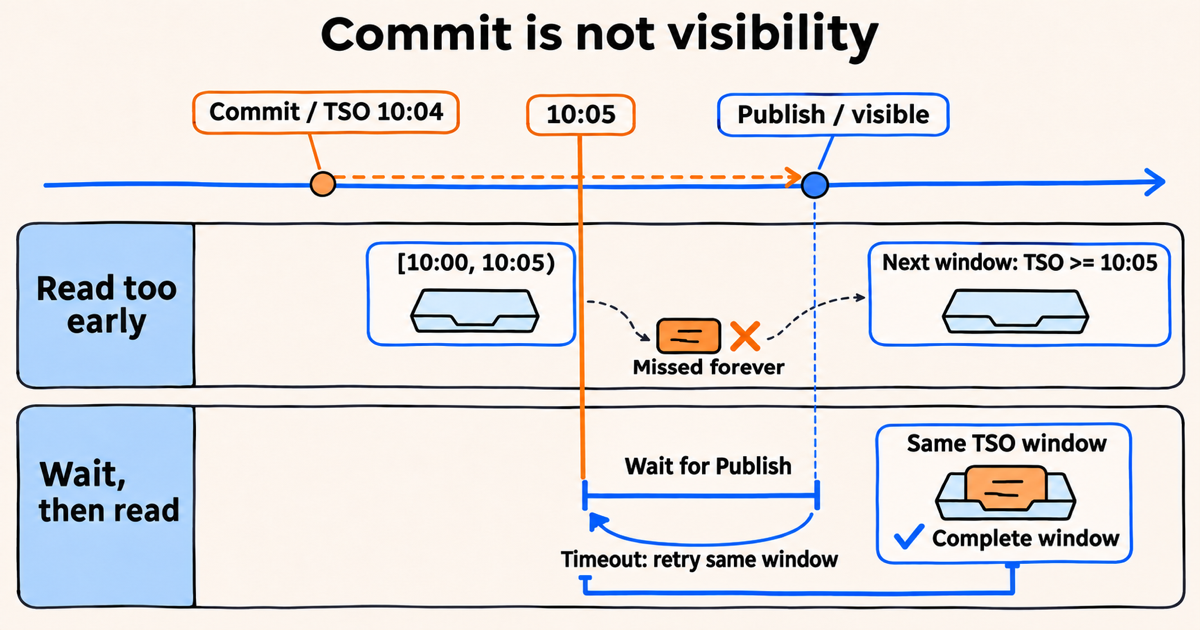
图 4:10:04 提交的事务属于 [10:00, 10:05),即使它在 10:05 之后才可见。读取前等待 Publish,才能在原时间范围内读全;超时则重试同一范围。
- 同一个事务内用 LSN 排序:同一个事务里的多行变化 TSO 相同,再用表内递增的序号 LSN 排出先后。同一行写往各个副本时带着同一个 LSN,所以各个副本记下的变化顺序一致。
1.4 Changelog 的生命周期管理
Changelog 默认保留 1 天,可以通过表属性 changelog.ttl_seconds 调整。过期的变化在查询时立即不可见,后台再逐步清理。
保留期(TTL)只看时间,不看下游是否已经读完。好处是简单:不用登记消费者,多个消费者互不影响,存储也有上限。代价是消费太慢的下游会丢数据:要读的起点已经过期时,DETAIL 和 APPEND_ONLY 会跳过过期的部分继续读,不报错;MIN_DELTA 和物化视图增量维护(IVM)则直接报错,因为缺了起点的旧值,就算不出正确的净变化。
所以保留期至少要覆盖“首次全量同步的耗时 + 最长的停机时间 + 恢复后追上进度的时间”,并监控下游的消费延迟。
1.5 Changelog 的消费逻辑
按时间范围跳过无关数据:每次导入写出的变化记录,都标着自己的 TSO 范围。读取时,会通过 TSO 进行文件裁剪,无需扫描整份 Changelog。
MIN_DELTA 合并:对每个主键,MIN_DELTA 只看时间范围内的第一条和最后一条变化。起点的值取第一条记录里的旧值,终点的值取最后一条记录里的新值。
起点不存在、终点存在,输出新增(+I);
起点存在、终点不存在,输出删除(-D);
前后都不存在,不输出;
前后都存在,输出一对 -U 和 +U;如果两边整行相同,说明没有净变化,不输出。
起点的值直接取自记录里的旧值,不用重新查询历史数据,这就是 MIN_DELTA 要求开启 before 镜像的原因。比较的是整行,只要有一列变了,也算一次更新。
库内与库外的消费者:库内的消费者有 Table Stream 和 IVM 两种。Table Stream 像读表一样持续消费一张表的变化,IVM 用变化增量刷新物化视图(用法见第三部分)。它们为基表的每个分区记一个 TSO 位点,把加工结果和新的位点放在同一个事务里提交,失败就一起回滚。外部系统无法参与 Doris 的事务,只能按时间范围读取,自己记录读到了哪里,Flink Doris Connector 就是这样的消费者。
1.6 Changelog 的代价与限制
开启 Changelog 后,每次导入都要多写一份变化记录,开启 before 镜像时还要逐行查出旧值,因此导入吞吐会下降,存储也会增加,幅度取决于表结构和更新比例。只需要同步新增数据时,用明细表或者不开 before 镜像,可以省掉查旧值的开销。目前 Changelog 只能在建表时开启,开启后表结构只支持轻量变更,也不支持备份恢复。
二、Flink Doris Connector:把变更传递至下游
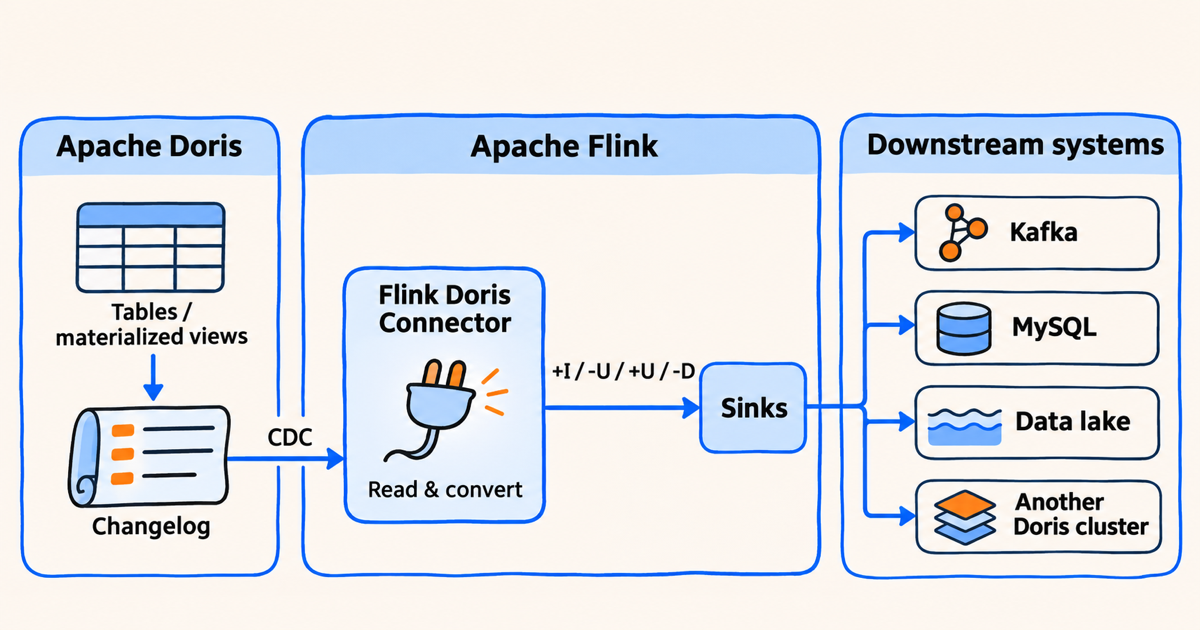
图 5:Doris 表和物化视图产生 Changelog,Flink Doris Connector 在 Flink 中读取并转换为变更流,再由 Sink 写入 Kafka、MySQL、数据湖或另一个 Doris 集群。
Doris 产生的 Changelog,一方面可以被 IVM 等内部流程消费,另一方面,也可以通过外部系统如 Flink Doris Connector 消费,转成 Flink 的变更流(+I、-U、+U、-D),写入 Kafka、MySQL、数据湖等下游系统,或另一个 Doris 集群。
2.1 使用方式:把 Doris 表声明为变更流
以 1.1 的订单表为例,要把订单的最新状态同步给客服系统,只需要在 Flink SQL 里声明一张 Doris 表:
SET 'execution.checkpointing.interval' = '10s';

CREATE TABLE order_changes (
    order_id BIGINT,
    status   STRING,
    PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
    'connector' = 'doris',
    'fenodes' = '<fe-host>:8030',
    'table.identifier' = 'shop.orders',
    'username' = '<doris-user>',
    'password' = '<doris-password>',
    'source.scan.mode' = 'initial',
    'source.changelog.increment-type' = 'min_delta'
);
这张表就是一条变更流:订单表的变化以 +I、-U、+U、-D 的形式持续流入 Flink,可以直接写入 MySQL、upsert-kafka 这类按主键更新的下游。其中有两项关键配置:
启动模式(
source.scan.mode):snapshot(默认,只读一次全量)、initial(先读取全量,再持续读取增量)、latest(从启动时刻开始读增量)、from-timestamp(从指定时刻开始读增量)。读取方式(
source.changelog.increment-type):对应 1.1 的三种读取方式,默认是detail。选min_delta时,每一轮读取的时间范围就是合并的范围。
initial 模式如何衔接全量与增量:Connector 先记下增量的起点,再读全量快照,所以起点之后提交的数据,要么在快照里,要么在增量里,不会遗漏。代价是可能重复:快照读到的是读取时刻的最新数据,从起点到快照读完这段时间里的变化,会在快照和增量里各出现一次。因此在 Connector 一侧,只能提供至少一次(at-least-once)的消费语义,需要下游通过主键表等能力配合实现精确一次(exactly-once)的消费语义。明细表没有主键,会出现真正的重复行,更适合用 latest 或 from-timestamp 只读增量,存量数据另行处理。
2.2 工作原理:按时间范围循环读取
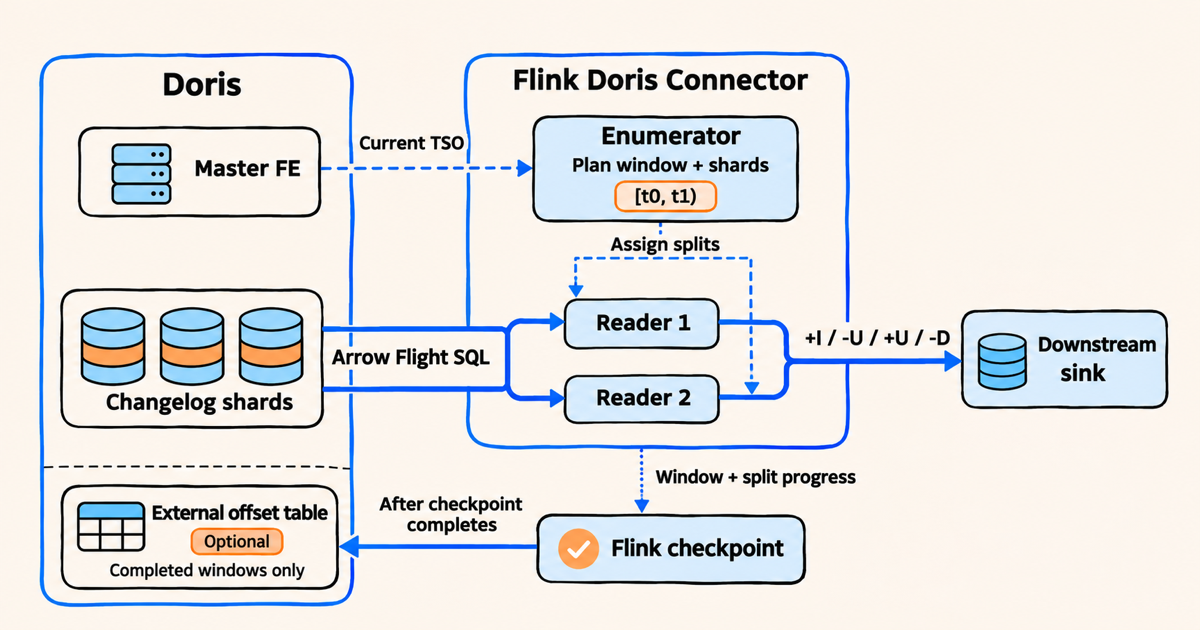
图 6:Enumerator 规划时间范围并分配分片,Reader 通过 Arrow Flight SQL 并行读取。checkpoint 保存读取进度;可选的外部位点表在 checkpoint 完成后更新,只记录全部读完的时间范围。
Connector 的增量读取由两个角色配合完成(图 6):
协调者(Enumerator) 每隔一段时间(
source.changelog.poll-interval,默认 10 秒)向 Doris 取一次当前的 TSO,切出一个新的时间范围,比如 [10:00:00, 10:00:10),再查出这段时间要读哪些 Changelog 分片,把读取任务分给各个读取者。读取者(Reader) 并行读取各自负责的分片,通过 Arrow Flight SQL 批量拉取数据,再把每条变化转成 Flink 的 +I、-U、+U、-D。
一个时间范围全部读完,才开始下一个。时间范围精确到秒,轮询间隔最小 1 秒,端到端延迟在秒级到十秒级。
2.3 故障恢复:从 checkpoint 恢复读取
Connector 把读取进度保存在 Flink 的 checkpoint 里:读到了哪个时间范围,哪些分片还没读完。作业失败后,从最近一次 checkpoint 恢复,没读完的分片从这个时间范围的起点重新读,已经读完的分片不再重读。所以恢复时会有一部分变化重复到达,但不会遗漏。
读取进度也可以同时写入一张 Doris 表(外部位点表,通过 source.changelog.offset-table 和 source.changelog.consumer-id 配置)。作业不从 checkpoint 恢复时(比如重建作业),可以从位点表接着读。位点表在每次 checkpoint 完成后更新,而且只记录全部读完的时间范围,所以用这种方式恢复,重读的范围更大一些。
此外,恢复的前提是,要读的变化还在 Changelog 的保留期内(见 1.4)。作业停得太久、起点已经过期时,detail 和 append_only 会跳过过期的部分,不报错;min_delta 则会报错。所以保留期要留足余量,并监控作业的消费延迟。
2.4 端到端 exactly-once
跨系统的链路无法共用一个事务。Connector 的做法是将 exactly-once 保障拆分为两个环节(图 7):Source 保证变化不丢(at-least-once),下游保证重复到达的变化最多生效一次(at-most-once),二者配合实现端到端 exactly-once。这里的 at-most-once 指“重复到达的变更最多被应用一次”,和常说的“最多投递一次、允许丢失”不是一回事。
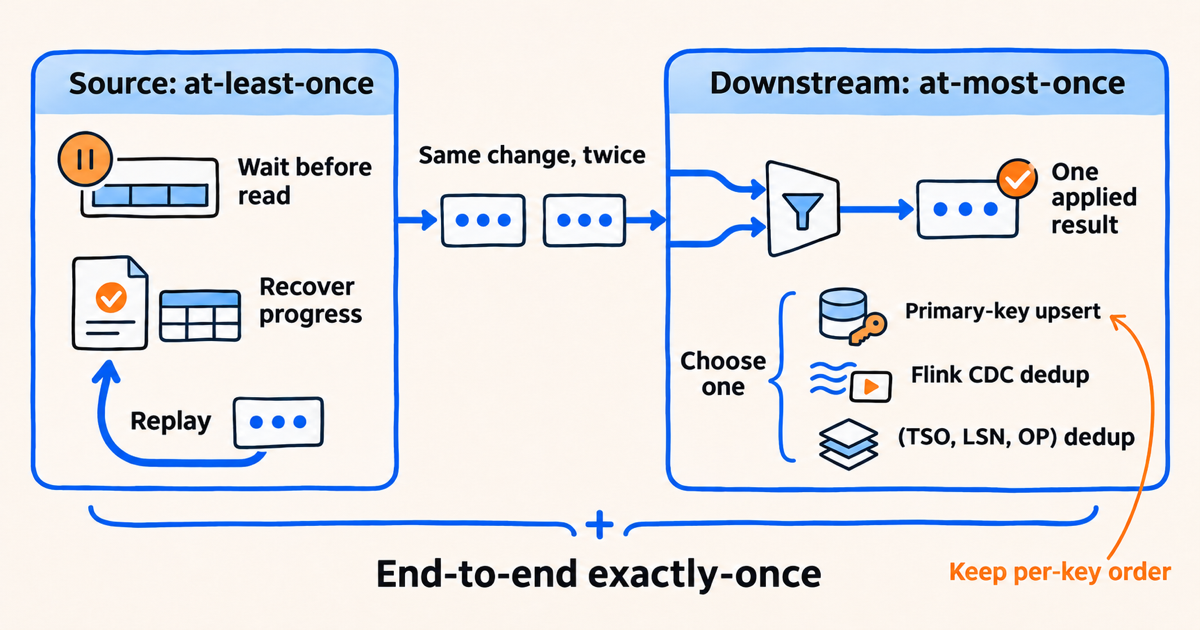
图 7:Source 保证变化不丢(at-least-once),下游保证重复到达的变化最多生效一次(at-most-once),共同实现端到端 exactly-once。按主键覆盖写时,还需要保持同一主键的变化顺序。
Source 端 at-least-once:读取前的等待(见 1.3)保证一个时间范围读过之后,不会再有新数据落进来,所以同一个时间范围不论重读多少次,读出的变化都一样;checkpoint 和外部位点表让进度可以恢复。Source 会在三种情况下重复发送变化:从 checkpoint 恢复、initial 模式下全量与增量的衔接、从外部位点表重启。
下游 at-most-once:常见的做法有三种:
写入主键表(Doris Unique Key 表、MySQL 等):按主键覆盖写,重复应用相同的幂等更新时,最终结果不变。
在 Flink 里继续做聚合、Join:源表声明主键,并开启
table.exec.source.cdc-events-duplicate,Flink 会按主键吸收重复的变化,代价是要为每个主键保存最新的一行。写入只追加的目标(普通 Kafka topic、文件):按 (TSO, LSN, OP) 去重,丢掉已经处理过的变化,这需要用 DataStream API 读取这三个字段;或者改用 upsert-kafka 这类按主键写入的方式。
按主键覆盖写,前提是同一个主键的变化按顺序到达:如果订单 1001 的“+U 已支付”先于“+I 待支付”写入,下游就会停在“待支付”上。Connector 怎样保证顺序,见 2.5。
2.5 按分片并行读取
Doris 的 Changelog 数据同样以分片的形式分散在多个节点中,因此可以通过并行读取的方式提高 Changelog 的消费速率。
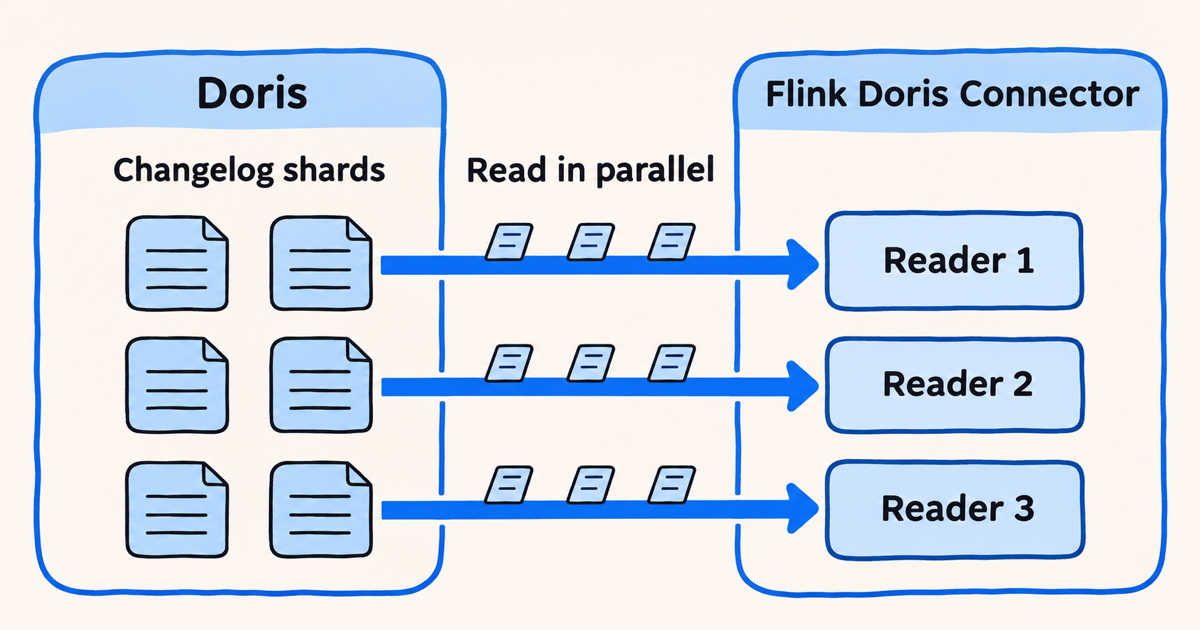
图 8:Doris 的 Changelog 分布在多个分片中,Flink Doris Connector 通过多个 Reader 并行读取。
Connector 按 Changelog 分片并行读取(图 8):
分配:协调者按分片编号的哈希,把分片分给各个读取者。并行度不变时,分配关系保持稳定,新增的分片也不会打乱已有的分配;分片较少时,分配可能不够均衡。
顺序:同一个主键的数据总在同一个分片里,由同一个读取者按顺序读出,时间范围之间又是读完一个再读下一个,因此 Source 端同一主键的变化可按序读出;不同分片之间不保证全局顺序。
同步:所有读取者读完当前时间范围,才开始下一个。最慢的分片决定整体的节奏,数据倾斜时尤其明显。
上限:有效并行度不超过 Changelog 的分片数,也就是各分区分桶数之和。建表时的分桶数,决定了下游消费能开多大的并行度。
作业扩缩容时,从 checkpoint 恢复,没读完的分片整段重读,之后按新的并行度分配。
三、Changelog 实战:在库内加工变化,再送到下游
前两部分介绍了 Changelog 的原理,以及 Connector 怎样将变化传递至下游。这一部分结合两个场景,介绍怎样基于 Changelog 解决更复杂的增量数据加工问题。
Changelog 提供了对数据原始变化的访问,但很多下游会有更复杂的变更数据要求,需要对 Changelog 进行再次加工。这类加工可以直接在 Doris 里利用增量物化视图或 Table Stream 完成:
物化视图增量维护(IVM):用 SQL 定义物化视图,Doris 根据基表的 Changelog,只更新受影响的那部分结果,不用每次全量重算。
Table Stream:像读表一样持续消费一张表的变化,由 Doris 记住每个消费任务读到了哪里。用 INSERT 语句消费时,写入加工结果和推进读取进度在同一个事务里完成,任务失败后重跑,不会漏,也不会重复。
存放加工结果的物化视图或普通表,同样可以开启 Changelog。这样,加工后的变化又是一份新的 Changelog,可以继续按 DETAIL 或 MIN_DELTA 读取,形成一个多级的加工链。
3.1 场景一:聚合结果的 Changelog 投递
业务需求:某广告平台按点击计费,每次点击的扣费流水实时写入 Doris。每个广告计划都设有预算,投放系统要实时掌握每个计划的累计消耗:达到预算就暂停投放;反作弊系统识别出无效点击后,会写入冲正流水退回扣费,消耗回落到预算以内,计划又可以恢复投放。投放系统关心的是结果,比如“计划 A 的累计消耗从 950 元变成了 1,000 元”。
如果只把扣费流水的变化送出去,投放系统就得自己维护每个计划的累计值:要么在 Flink 里把聚合再写一遍,为所有计划保存状态;要么定时回查 Doris,延迟高,查询资源开销大。
解决方案:聚合物化视图 + 物化视图的 Changelog。用一条 SQL 定义按广告计划汇总消耗的物化视图,设为每次导入提交后自动增量刷新:Doris 只根据新到的流水更新受影响的计划,不重算全部数据。物化视图本身开启 Changelog 和 before 镜像,每次刷新,累计消耗的变化都会被记录下来(图 9)。
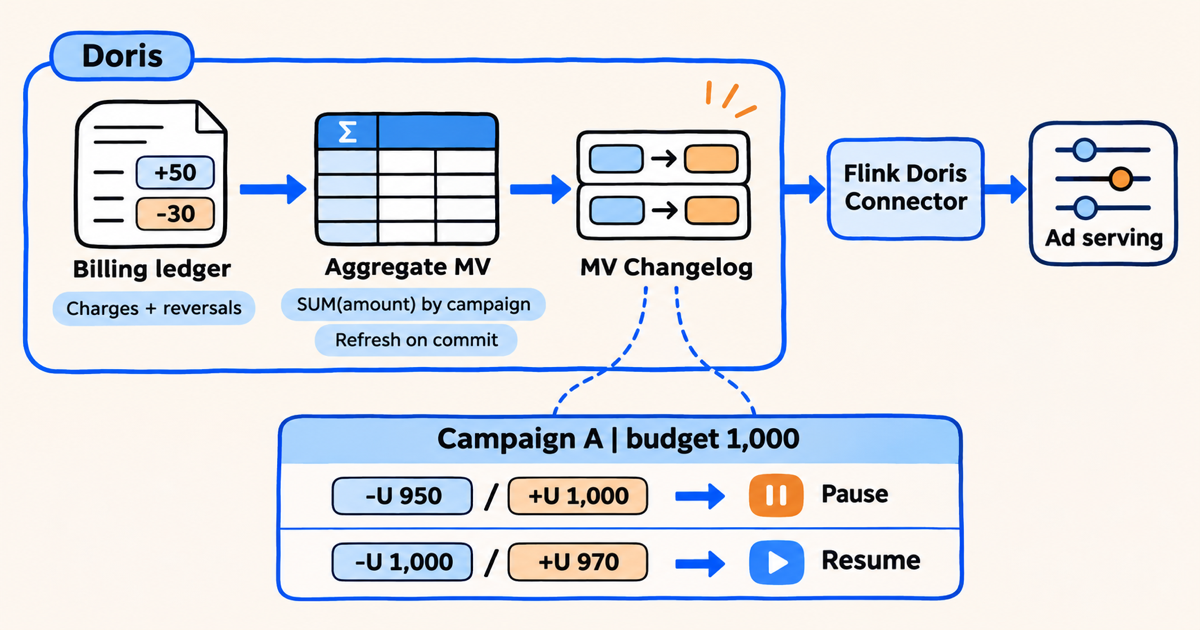
图 9:Doris 在导入提交后增量刷新聚合物化视图,将累计消耗的变化送到投放系统。预算为 1,000 元时,消耗达到预算暂停投放,冲正后降到 970 元则恢复。
对应的 SQL 如下(在 ads 库中执行):
-- 扣费流水表:明细表,开启 Changelog;冲正流水的金额记为负数
CREATE TABLE click_billing (
    campaign_id  BIGINT,
    billing_time DATETIME,
    amount       DECIMAL(18, 2)
)
DUPLICATE KEY (campaign_id, billing_time)
DISTRIBUTED BY HASH(campaign_id) BUCKETS 16
PROPERTIES ("changelog.enable" = "true");

-- 按广告计划汇总消耗:每次导入提交后自动增量刷新,
-- 物化视图本身开启 Changelog 和 before 镜像
CREATE MATERIALIZED VIEW campaign_spend_mv
BUILD IMMEDIATE REFRESH INCREMENTAL ON COMMIT
KEY (campaign_id)
DISTRIBUTED BY HASH(campaign_id) BUCKETS 16
PROPERTIES (
    "changelog.enable" = "true",
    "changelog.need_historical_value" = "true"
)
AS
SELECT campaign_id, SUM(amount) AS spend
FROM click_billing
GROUP BY campaign_id;
以计划 A(预算 1,000 元)为例:
| 时间 | 发生了什么 | 累计消耗(元) | 物化视图 Changelog 里的记录 |
|---|---|---|---|
| 10:00:01 | 第一批扣费 | 800 | +I 800 |
| 10:00:04 | 新一批扣费 | 950 | -U 800,+U 950 |
| 10:00:08 | 新一批扣费,达到预算 | 1,000 | -U 950,+U 1,000 |
| 10:00:15 | 冲正 30 元无效点击 | 970 | -U 1,000,+U 970 |
这种方案利用了 Doris 的聚合计算能力,将聚合结果的变化以 Changelog 形式提供给下游。如果投放系统只关心每个计划最新的累计消耗,不需要中间值,可以用 MIN_DELTA 读取物化视图的 Changelog。比如每 10 秒读一轮,第一轮的查询是:
SELECT __DORIS_CHANGELOG_OP__ AS op, campaign_id, spend
FROM campaign_spend_mv@incr(
    'startTimestamp' = '2026-11-11 10:00:00',
    'endTimestamp'   = '2026-11-11 10:00:10',
    'incrementType'  = 'MIN_DELTA'
);
这一轮里,计划 A 从无到 800、950 再到 1,000,只输出一条 +I 1,000,投放系统据此暂停这个计划;第二轮 [10:00:10, 10:00:20) 输出 -U 1,000 和 +U 970,计划恢复投放。大促期间计划多、扣费频繁,同一轮里的多次变化只输出一次净变化,投放系统要处理的消息会少很多。如果还要画消耗曲线或者对账,就用 DETAIL 保留每一次变化。
不过,点击流水量很大,很多平台只保留最近几天,但物化视图为了确保语义正确,需要保留基表的全部数据(即全部明细数据)。此时,可以使用 Table Stream + 定时作业 的方式,将流水表作为缓冲区:用 Table Stream 读取新到的流水,由定时作业每分钟把这批流水按计划汇总,累加到一张开启了 Changelog 的结果表上(图 10)。基表和结果表的数据生命周期可以完全独立管理,从而灵活控制明细数据的存储成本。
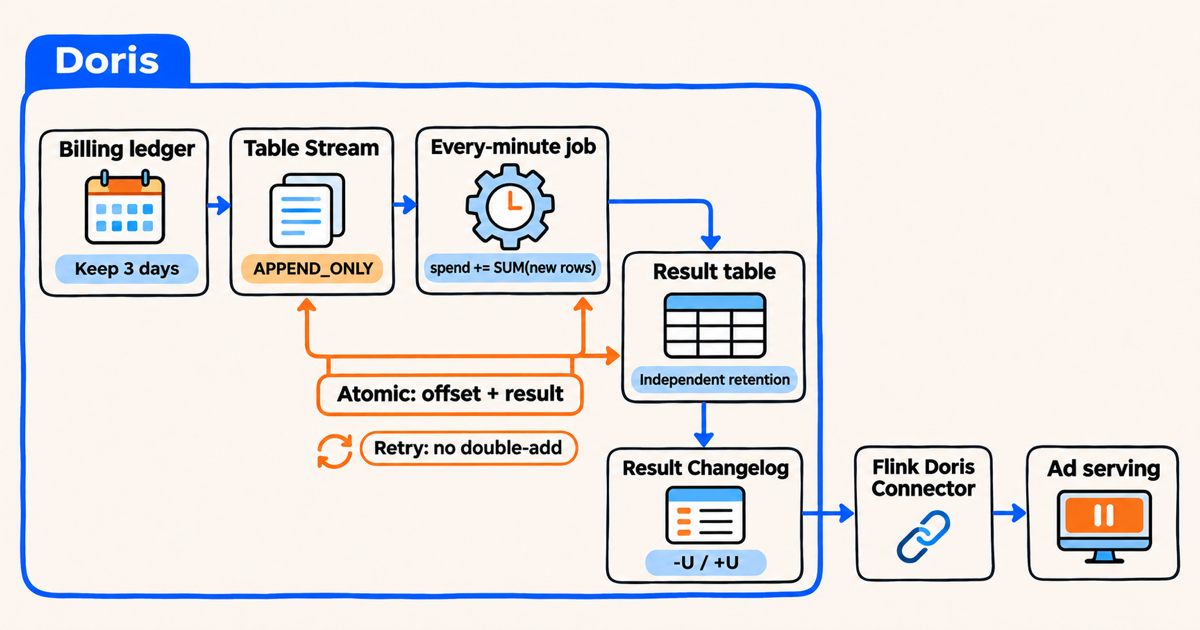
图 10:Table Stream 只读取新到的流水,定时作业每分钟累加到结果表。流水保留 3 天,结果表的生命周期独立管理;Stream 位点与结果更新在同一事务中提交,重试不会重复累加。
这种做法里,流水表可以按天分区、只保留最近 3 天,开启 Changelog 的方式与前面相同。结果表、Stream 和定时作业的 SQL 如下:
-- 结果表:主键表,开启 Changelog 和 before 镜像
CREATE TABLE campaign_spend (
    campaign_id BIGINT,
    spend       DECIMAL(38, 2)
)
UNIQUE KEY (campaign_id)
DISTRIBUTED BY HASH(campaign_id) BUCKETS 16
PROPERTIES (
    "enable_unique_key_merge_on_write" = "true",
    "changelog.enable" = "true",
    "changelog.need_historical_value" = "true"
);

-- 在流水表上建 Stream,只读取建 Stream 之后新到的流水
CREATE STREAM click_billing_stream ON TABLE click_billing
PROPERTIES ("type" = "append_only", "show_initial_rows" = "false");

-- 每分钟把新到的流水按计划汇总,累加到结果表
CREATE JOB campaign_spend_job
ON SCHEDULE EVERY 1 MINUTE
DO
INSERT INTO ads.campaign_spend
SELECT d.campaign_id, COALESCE(s.spend, 0) + d.delta
FROM (
    SELECT campaign_id, SUM(amount) AS delta
    FROM ads.click_billing_stream
    GROUP BY campaign_id
) d
LEFT JOIN ads.campaign_spend s ON s.campaign_id = d.campaign_id;
每轮作业里,读取 Stream 和写入结果表在同一个事务里完成,失败就一起回滚,重跑时不会重复累加。结果表的 Changelog 同样是累计消耗的变化。
两种做法的结果都在开启了 Changelog 的表里,可以由 Flink Doris Connector 直接读取,送到投放系统(写法见 2.1)。
3.2 场景二:乱序多流合并的 Changelog 语义处理
业务需求:某电商平台的商品数据通过两条链路写入 Doris 的商品表。实时链路用 CDC 同步业务库的每一次修改;校对链路每天把业务库的全量数据重新同步一遍,补上实时链路可能漏掉的数据。Doris 再把商品的最新价格同步给搜索引擎。搜索引擎只关心价格:价格变了,就更新索引;商品删除了,就从索引中移除。
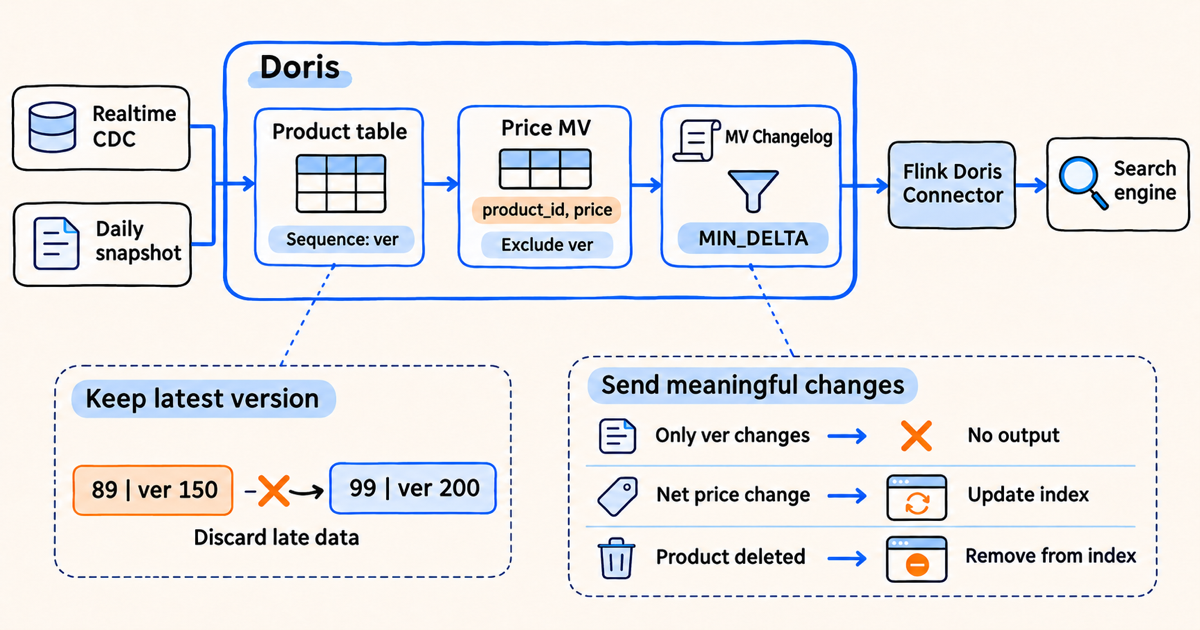
图 11:实时 CDC 与每日全量校对共同写入商品表,sequence 列 ver 保证迟到的低版本数据不会覆盖新值;不含 ver 的价格物化视图配合 MIN_DELTA,只把价格净变化和删除送到搜索引擎。
用版本号处理乱序:两条链路的数据到达 Doris 的顺序无法保证,晚发生的修改可能先到。为此,商品表把版本号列 ver 设为 sequence 列:对同一个主键,Doris 按 sequence 列的大小而不是到达的先后决定哪条数据最新,版本更低的迟到数据会被丢弃。ver 取的是每条数据的事件时间:实时链路取业务库修改发生的时间,校对链路取全量快照的时间。商品表的建表语句如下(在 shop 库中执行):
-- 商品表:ver 是 sequence 列;开启 Changelog 和 before 镜像,供下文的物化视图增量刷新
CREATE TABLE product (
    product_id BIGINT,
    price      DECIMAL(10, 2),
    ver        BIGINT
)
UNIQUE KEY (product_id)
DISTRIBUTED BY HASH(product_id) BUCKETS 16
PROPERTIES (
    "enable_unique_key_merge_on_write" = "true",
    "function_column.sequence_col" = "ver",
    "changelog.enable" = "true",
    "changelog.need_historical_value" = "true"
);
例如,一件商品原价 99 元(ver = 100),在 ver = 150 时促销降到 89 元,ver = 200 时恢复为 99 元,而 150 这次修改在链路里延迟,最后才到达:
| 到达顺序 | 写入的数据 | 商品表中的结果 |
|---|---|---|
| 1 | 99 元,ver = 100 | 99 元,ver = 100 |
| 2 | 99 元,ver = 200 | 99 元,ver = 200 |
| 3 | 89 元,ver = 150(迟到) | ver 低于 200,被丢弃,仍为 99 元,ver = 200 |
只有版本号变化的更新:每次全量校对,校对链路都会以新的 ver 把所有商品重写一遍,而绝大多数商品的价格并没有变。这些更新如果都同步出去,搜索引擎就要做大量无效的索引更新。
为什么不能在写入时丢掉这些更新? 看上表的第 2 条:在 Doris 看来,它的价格也没变,只是 ver 变了。如果因为价格没变就把它丢掉,商品表的 ver 会停在 100,第 3 条迟到的 89 元就会被当成新数据写入,价格就错了。所以商品表必须照常记录每一次写入,只有版本号变化的更新,只能在同步给下游时过滤。
为什么直接读 MIN_DELTA 也不行? MIN_DELTA 会合并一段时间内的多次变化,但判断“有没有变”时比较的是整行,ver 也在其中:价格没变、ver 变了,仍然算一次更新。
- 解决方案:不含 ver 的物化视图 + MIN_DELTA。建一个只包含商品 ID 和价格、不含 ver 的物化视图,开启 Changelog 和 before 镜像。只有 ver 变化时,物化视图里这一行的前后值完全相同,以 MIN_DELTA 读取时,这次“更新”就被消除了。
-- 价格物化视图:只保留商品 ID 和价格,不含 ver
CREATE MATERIALIZED VIEW product_price_mv
BUILD IMMEDIATE REFRESH INCREMENTAL ON COMMIT
KEY (product_id)
DISTRIBUTED BY HASH(product_id) BUCKETS 16
PROPERTIES (
    "changelog.enable" = "true",
    "changelog.need_historical_value" = "true"
)
AS
SELECT product_id, price FROM product;

-- 同步任务每 10 秒读一轮物化视图的净变化
SELECT __DORIS_CHANGELOG_OP__ AS op, product_id, price
FROM product_price_mv@incr(
    'startTimestamp' = '2026-11-11 10:00:00',
    'endTimestamp'   = '2026-11-11 10:00:10',
    'incrementType'  = 'MIN_DELTA'
);
按这种方式同步,不同情形下每一轮的输出如下(一轮指相邻两次读取之间的时间段):
| 这一轮里发生了什么 | MIN_DELTA 读出的变化 | 同步给搜索引擎 |
|---|---|---|
| 全量校对重写,价格不变,只有 ver 变化 | 无 | 无 |
| 价格从 99 元降到 89 元 | -U 99,+U 89 | 更新为 89 元 |
| 价格降到 89 元,又恢复为 99 元 | 无 | 无 |
| 商品被删除 | -D 99 | 删除 |
同样,最终结果的 Changelog 可以由 Flink Doris Connector 直接读取并投递到下游(写法见 2.1)。
结语
基于 Changelog,Doris 从数据链路的终点进一步扩展为链路中的实时计算节点。这使 Doris 能够在承接实时数据写入与分析查询的同时,向下游持续提供加工后的数据变化,为实时数据处理链路提供更多选择。
下一篇将深入 IVM 内核,介绍增量执行计划的生成机制。
Changelog 计划于 Apache Doris 5.0 版本正式推出,敬请期待!