实时分析往往不只需要最新数据,还需要结合历史记录和当前状态,才能准确判断业务变化。
以自动驾驶路测为例,某个路口的人工接管事件突然增多,团队需要结合当天的测试车次、车辆状态,以及过去几周的记录,判断接管频率是否真的出现异常。
这类分析涉及持续写入的新事件、不断更新的状态数据,以及已经归档的历史数据。如果数据分散在不同系统中,往往需要额外的同步和拼接,增加了分析链路的复杂度。
Apache Fluss 通过湖流一体架构组织这些数据。Apache Doris 5.0 新增 Fluss Catalog,支持直接查询 Fluss 表,并通过 Union Read 统一读取湖中历史和最新增量。
本文将介绍 Fluss 的设计思路、Doris 5.0 的集成能力,并结合自动驾驶路测场景和性能测试,分析其实际应用与使用边界。
一、Fluss 湖流一体设计思路
1. 把事件流和当前状态放在同一张表中
在常见的实时分析链路中,新事件先进入消息系统,计算任务再把它们同步到状态库或分析系统。分析人员要查询最近发生的事,得等同步完成;如果还要查询历史和当前状态,就得分清几份数据各自覆盖的范围。
Apache Fluss 把事件存储、流式消费和表结构放在一起。在适合的链路中,它可以承担独立消息系统原先负责的事件接入与分发。数据继续供下游流式消费,也能通过带 Schema 的表参与分析。团队因此可以省去一条专为查询最新事件建立的同步链路;查询只需部分字段时,列式组织也有助于减少宽表读取。
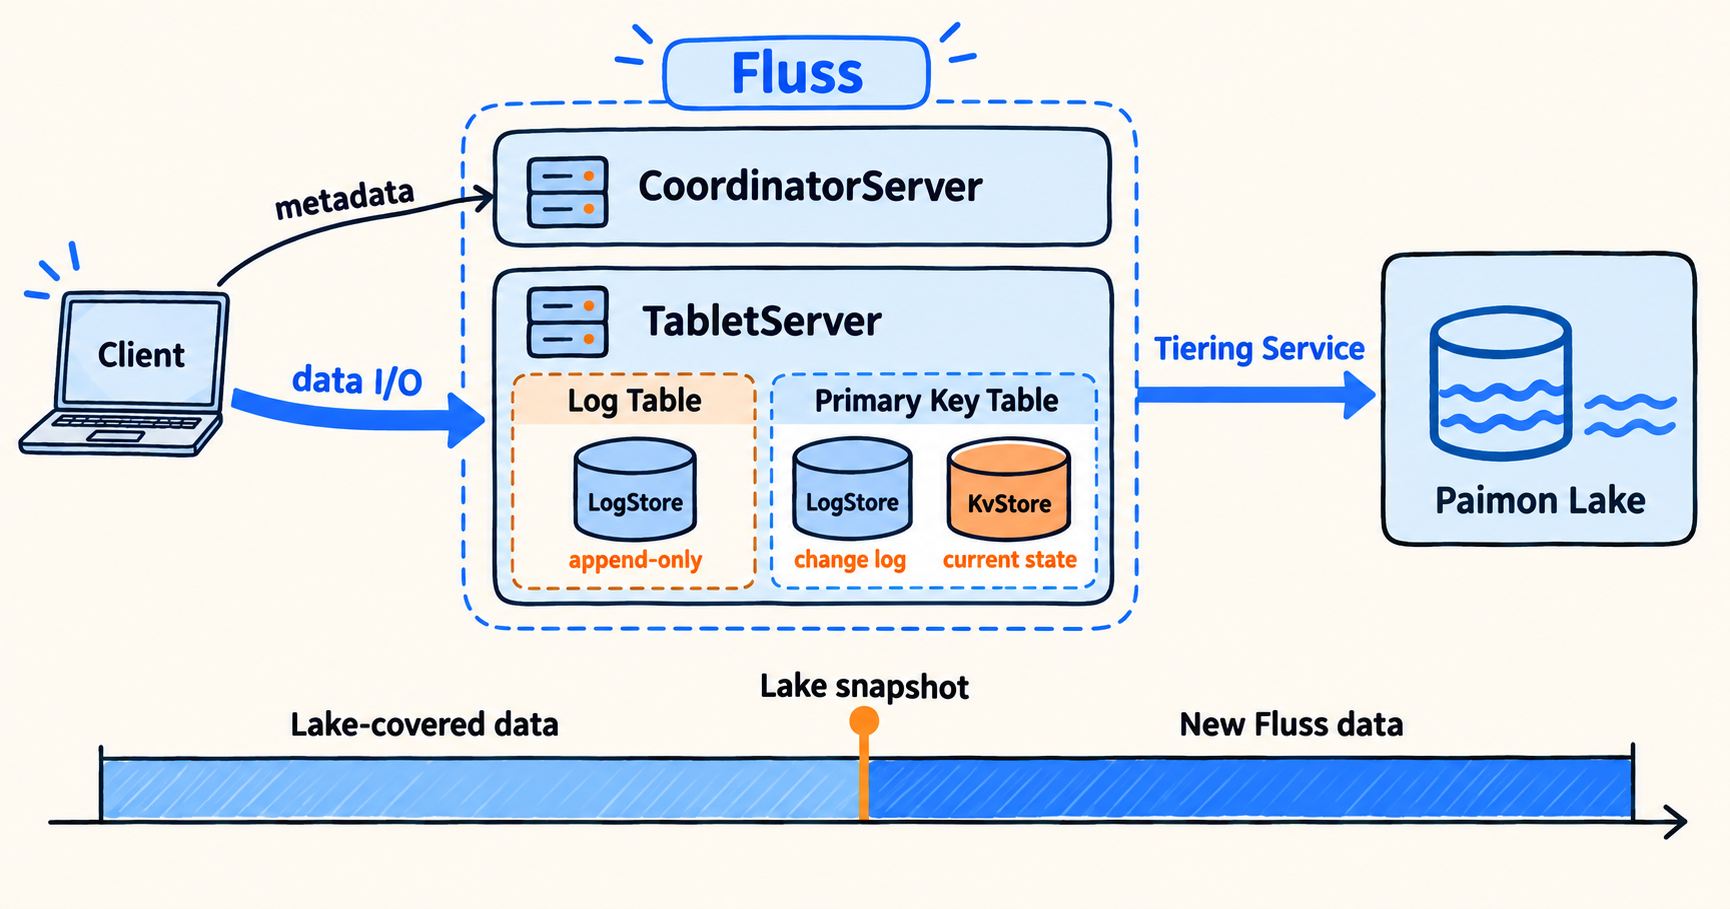
Fluss 有两类表:
| 表类型 | 适合存什么 | 如何读取 |
|---|---|---|
| 日志表 | 接管事件、通行记录、设备告警等只追加的数据 | 按写入顺序保留事件,供下游持续读取和分析 |
| 主键表 | 车辆状态、设备配置、活动规则等会更新的数据 | 按主键维护当前值,同时保留变更日志 |
同一张表的数据又分为 Log 和 Lake 两层。Log 保留近期写入的数据;分层服务把较早的数据写入采用开放格式的 Lake。可读湖快照记录了数据已入湖的位置,查询引擎据此确定历史和最新增量的边界。
2. 用 SQL 分析 Fluss 中的数据
事件和状态写入 Fluss 后,分析人员还需要做聚合、关联和明细排查。例如,刚出现的波动与历史相比有多大,又集中在哪些设备或用户?Doris 可以直接查询 Fluss 表,用 SQL 回答这类问题。
| 场景 | 想回答的问题 | 需要的数据 |
|---|---|---|
| 运营活动监测 | 刚出现的转化波动是否超出以往同类活动的水平? | 最新行为事件、历史趋势、活动当前状态 |
| 设备与车队分析 | 新告警集中在哪些设备,过去是否出现过类似异常? | 实时事件、长期运行记录、设备当前状态 |
| 风险事件复核 | 新出现的异常信号是否与历史模式相关? | 最新事件、历史明细、持续更新的对象状态 |
以自动驾驶路测为例:某个路口的人工接管事件突然增多。团队先查最近半小时的记录,再把接管次数与经过该路段的测试车次一起统计,同过去几周的相同时段比较。接管总数增加,也许只是当天经过的车辆更多;如果接管频率也升高,就需要继续排查。
接着,团队核对车辆的当前状态,锁定车次和时间窗口,再调阅行车记录。
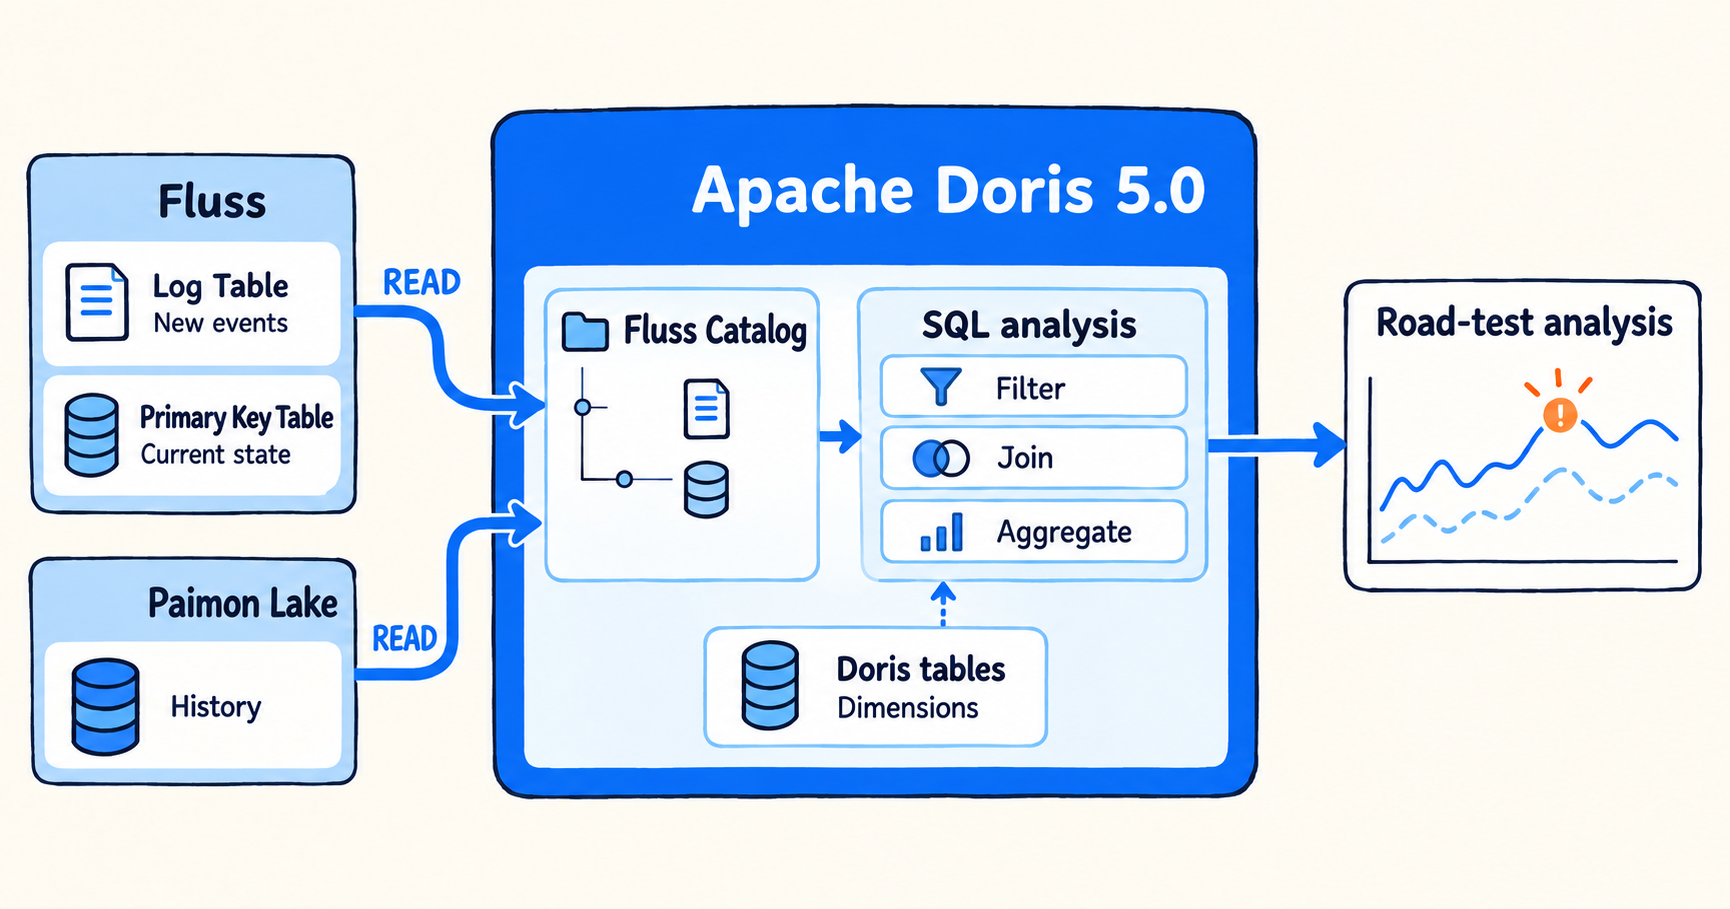
Doris 5.0 新增的 Fluss Catalog 让 Fluss 表直接参与 SQL 分析。如果表已分层到 Paimon,一次查询还能读到已入湖历史和尚未入湖的增量。
二、使用 Doris 访问 Fluss 的新事件、历史和当前状态
1. 查询刚写入的事件
路测团队首先要按路段、触发原因和事发时的软件版本筛选近期接管记录。若还要等另一条任务把事件搬进 Doris,第一轮排查就会晚一步。
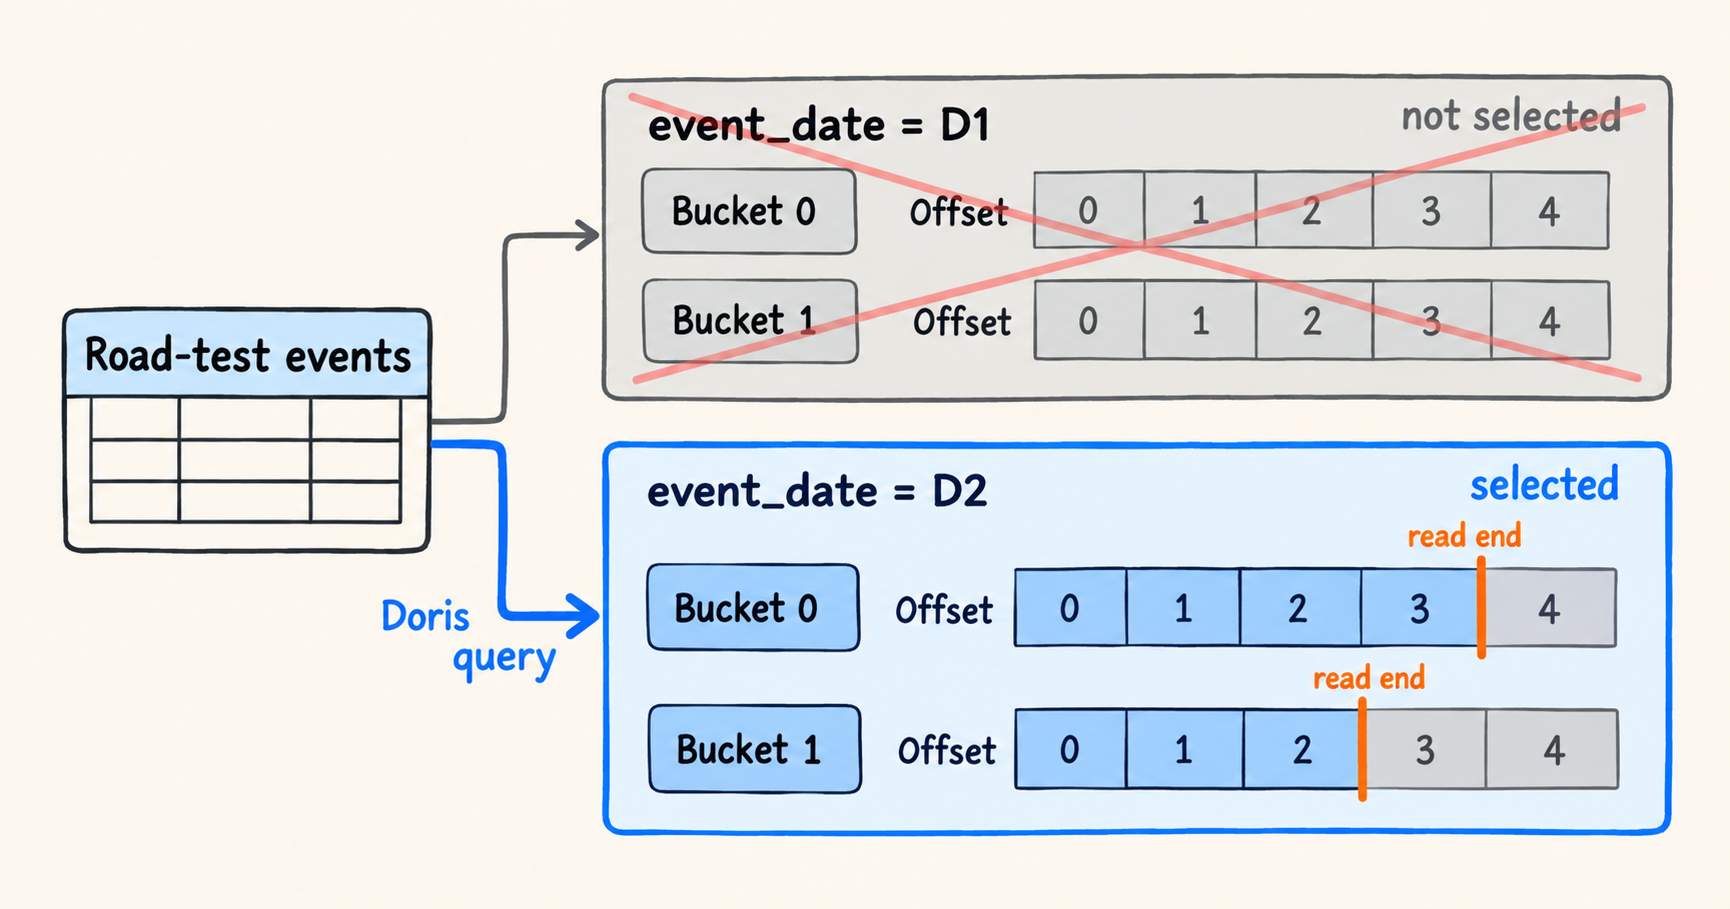
Fluss 将一张表的数据分散到多个 Bucket(分桶),以便并行读写。分区表的数据先进入对应分区,再分布到分区下的 Bucket;未分区的表直接分桶。每个 Bucket 都有独立的 Offset(位点),表示记录在该桶日志中的位置。
通过 Fluss Catalog,Doris 可以直接查询 Fluss 日志表,并对结果做过滤、聚合或关联。查询也能结合 Doris 内表中的车型、测试计划等维度。对于反复使用且口径固定的结果,团队仍可按需写入 Doris 内表。
Fluss Catalog 呈现 Fluss 中的数据库、表和字段。分析人员可以先查看有哪些事件表和状态表,再用 Doris SQL 排查异常。源表仍由 Fluss 管理,是否将查询结果存入 Doris 由具体任务决定。
一次查询只读取规划时确定的数据:Doris 为各 Bucket 固定日志结束位置,读到该位置便结束。之后写入的记录留给下一次查询。这样,每次执行都得到一个有界的结果。
2. 拼接湖中历史和 Fluss 中的新事件
要判断当前波动是否异常,路测团队可能需要比较同一路段过去几周的早高峰。近期的接管和通行事件却还没有进入 Paimon 的可读快照。分别查询湖和日志再手工拼接,很难确认两边是否读重或漏读。
每个 Bucket 都有自己的日志位置。分层服务把一段日志写入 Paimon,提交可读湖快照,并记录各 Bucket 写到了哪里。快照之后的记录仍从 Fluss 读取。
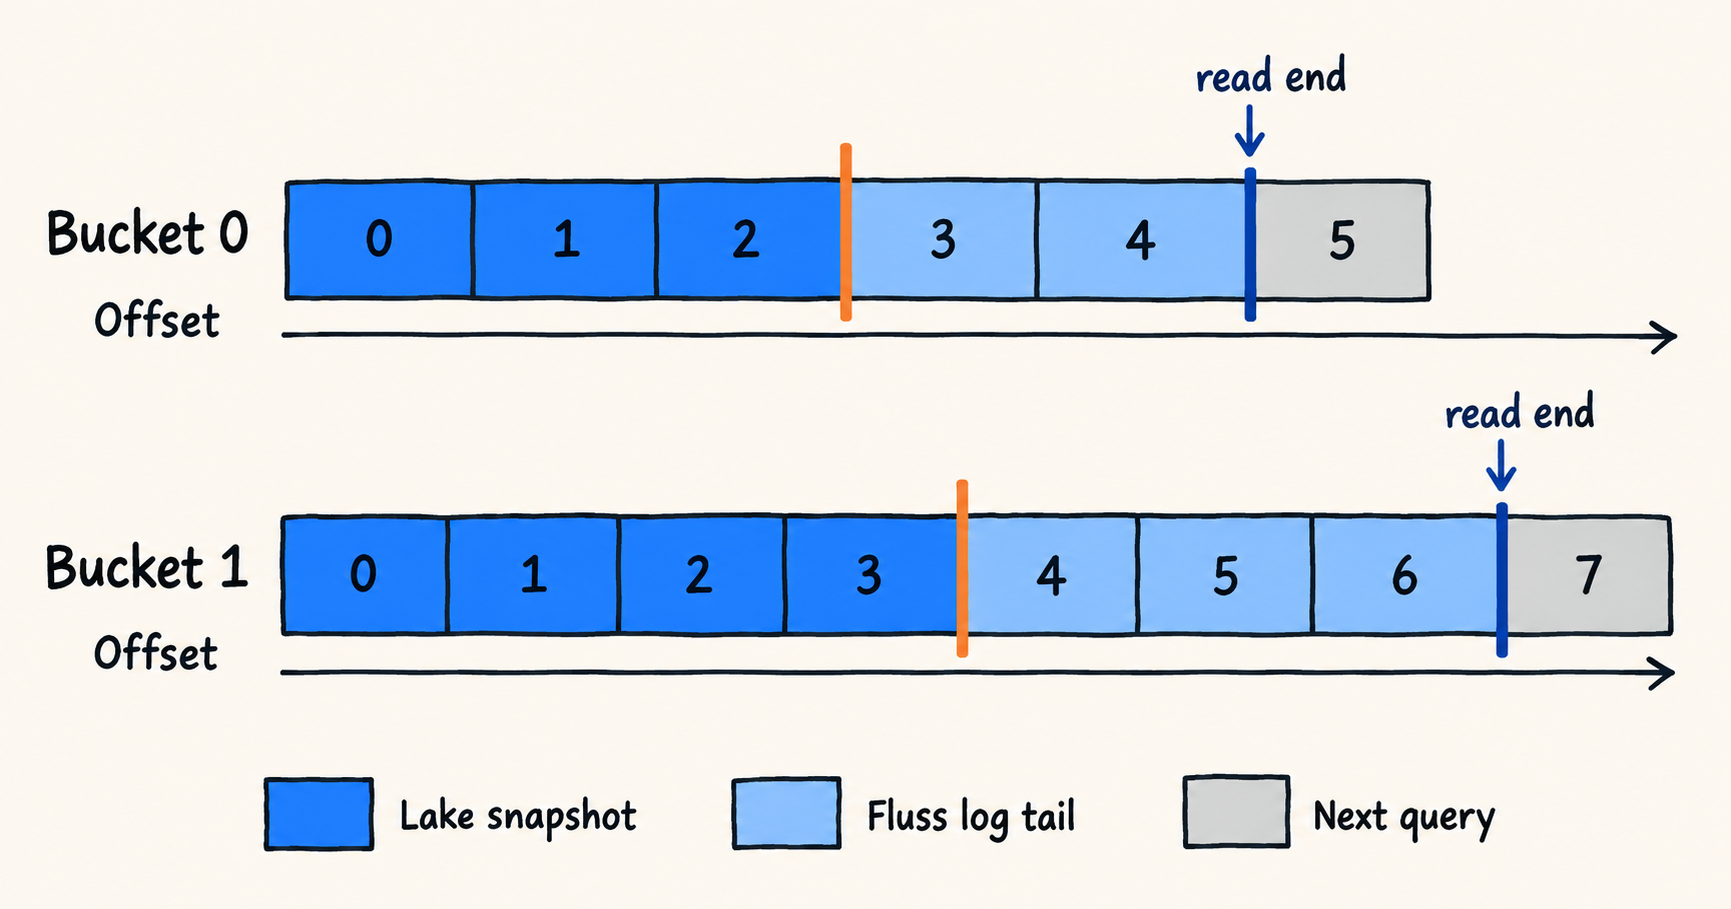
对于开启湖仓分层的 Fluss 表,Doris 提供 Union Read。查询开始时,它固定本次读取的 Paimon 快照,再确定各 Bucket 的日志终点。湖端读取快照覆盖的历史,Fluss 端从入湖位置读到本次终点。分析人员查询的是同一张逻辑表,无需自己拼接两侧结果;查询期间新到达的记录留给下一次查询。
接管事件这类追加式日志按位点衔接,减少两侧读重或漏读。需要核对分层进度时,也能分别查看湖端和日志端。如果尚无可读湖快照,默认查询只能读取 Fluss 当前保留的数据。依赖完整历史的任务,应先确认快照就绪,并检查日志保留范围。
3. 还原主键表的当前值
事件之外,车辆运行状态、设备配置等对象也会变化。一辆车可能先是“路测中”,后来变为“待检修”。如果直接把两次变更都算作当前状态,报表就会同时出现新旧两个版本。
主键表有两种读取基线。从 Fluss 还原完整状态时,Doris 读取 KV 快照和此后的变更日志。已分层的表使用 Union Read 时,则以 Paimon 湖快照为基线,接上湖快照之后的 Fluss 变更日志。正常的 Union Read 不会把 KV 快照与湖快照相加。
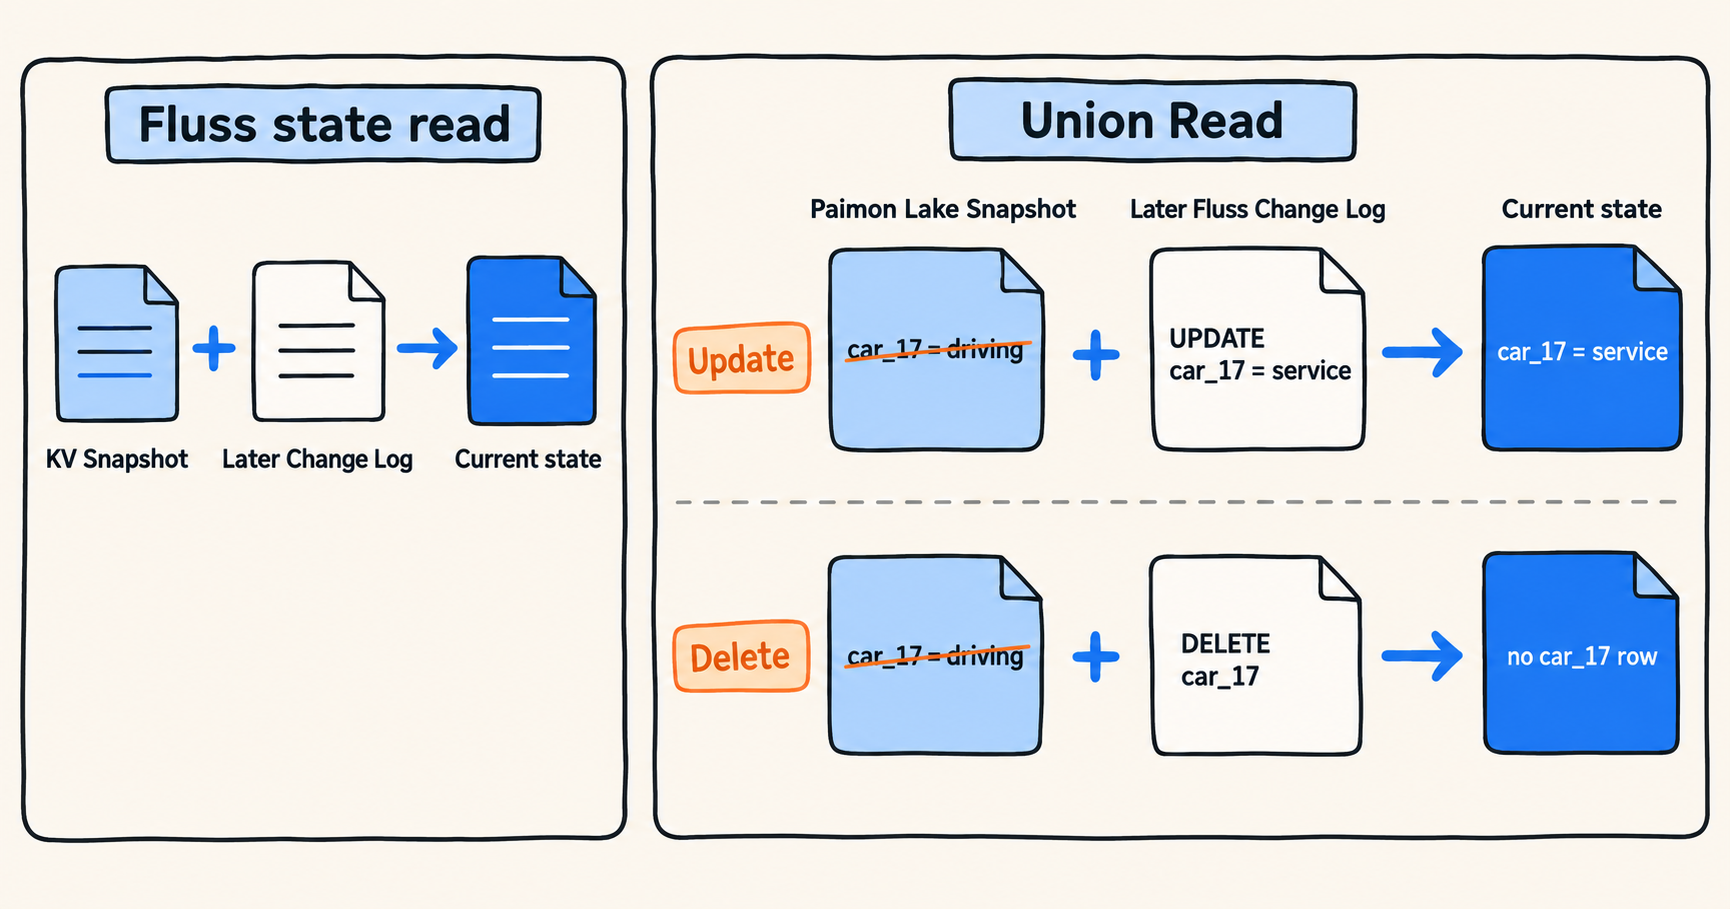
图 :两条路径分别以 KV 快照和湖快照为基线。Union Read 中,更新返回新值,删除后不再返回该主键。
Union Read 会找出日志尾部涉及的主键,过滤湖中这些主键的旧行,再输出尾部合并后的当前值。更新只留下新状态,删除则移除该主键;一辆车不会因为湖和日志各有一条记录而被重复计数。
路测分析中,事件表记录的是事发时的软件版本,车辆状态表用于核对现在运行的版本。这两个时间点不能混用。
4. 按任务选择读取范围
异常趋势分析要同时看历史和新事件;已归档月份的基线报表只需湖中数据;核对分层进度,则要查看尚未入湖的日志。对于开启 Paimon 分层的 Fluss 表,Doris 提供三个查询入口:
| 查询入口 | 读取范围 | 用途与限制 |
|---|---|---|
| 直接查询表名 | 正常使用 Union Read,覆盖湖中历史和尚未入湖的变化 | 适合同时分析历史和最新数据;默认模式在条件不满足时可能调整读取路径 |
表名$lake |
只读 Paimon 中已分层的数据 | 可核对历史基线或入湖结果;不包含尚未入湖的新记录 |
表名$log |
只读可读湖快照之后的 Fluss 日志 | 可核对追加式事件表的增量;不含湖中历史,也不适用于主键表 |
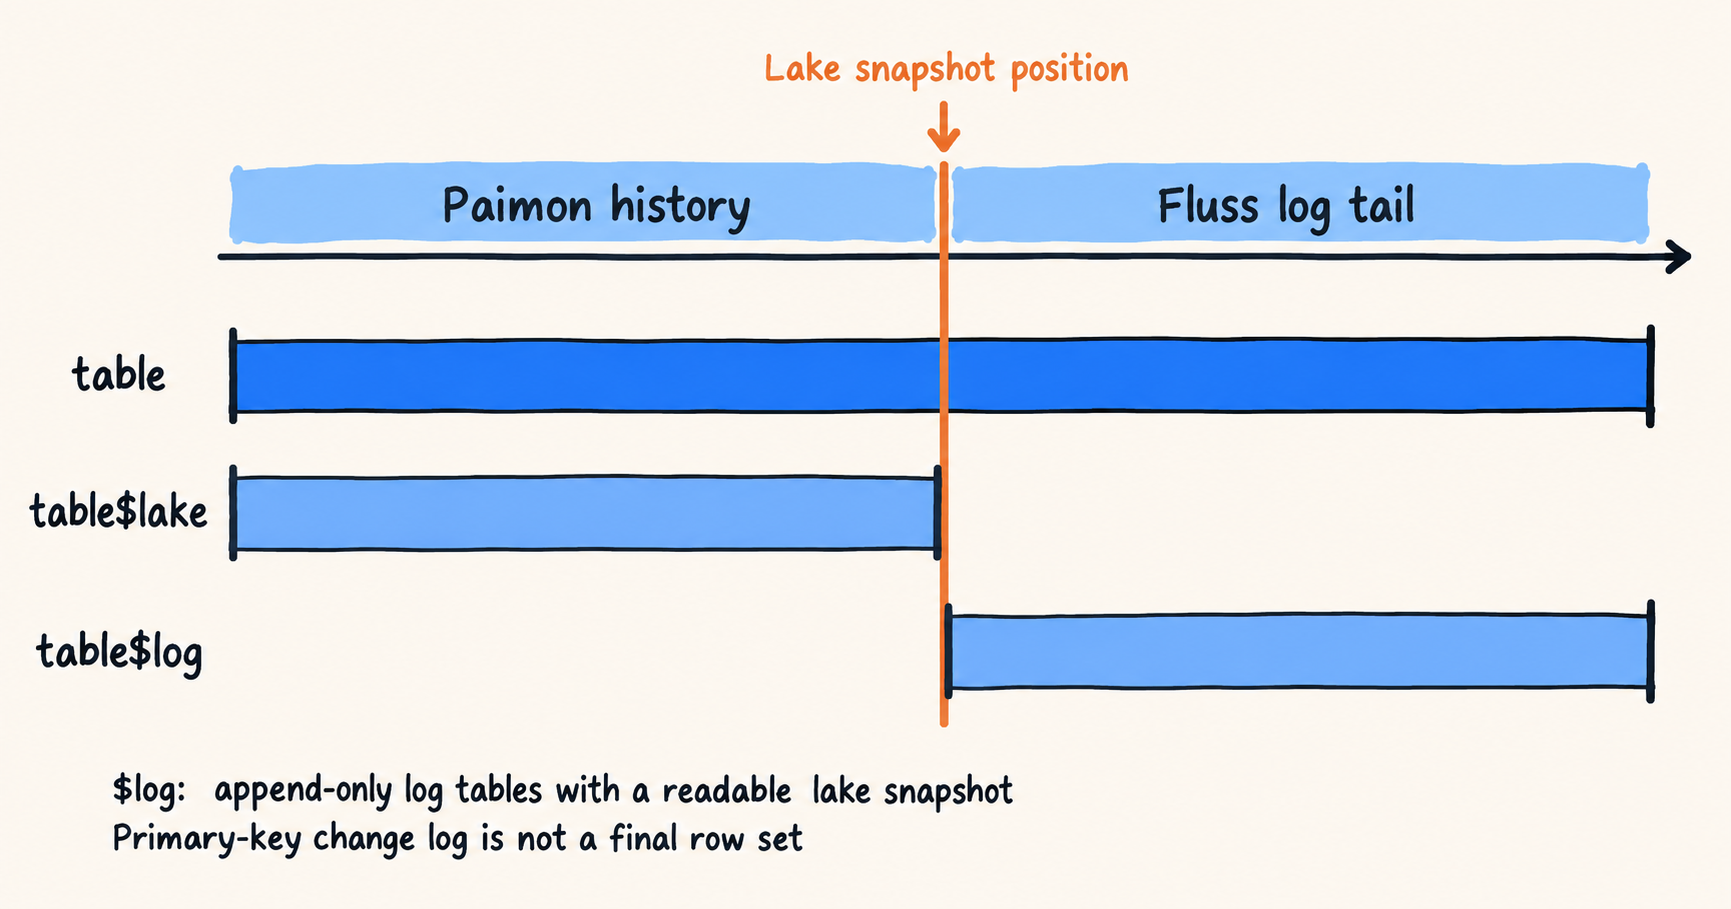
图 6:直接查表名覆盖湖与日志;**$lake* 只读湖端,$log 只读可读湖快照之后的追加式日志。*
直接查询表名时,fluss.union_read.mode 决定 Doris 如何选择读取路径。$lake 和 $log 则已经指定了要读的数据段。
| 模式 | 查询整张表时的行为 | 适合何时使用 |
|---|---|---|
auto(默认) |
有可读湖快照且条件满足时使用 Union Read;否则调整读取路径,优先返回当前可读的数据 | 日常分析,优先保证查询可用 |
required |
必须实际使用湖端;无法安全执行 Union Read 就报错 | 上线验收,确认历史与增量按预期衔接 |
disabled |
不读湖端,只读 Fluss 当前可用的数据 | 临时隔离湖端问题,或对比两条读取路径 |
$log 与 disabled 的起点不同。前者从湖快照记录的入湖位置开始读;后者对日志表读取 Fluss 当前仍保留的记录,对主键表则还原当前状态。如果较早的日志已从 Fluss 清理,disabled 查询日志表时就读不到那些只存在于湖中的历史。
读取范围确定后,还可以检查扫描量和实际执行路径:
湖端复用 Doris 的 Paimon 读取能力和文件缓存。带上分区条件、只选择需要的字段,可以减少扫描与解码。普通数据列的过滤能保证结果正确,但未必减少源端读取。
入湖滞后会拉长待合并的主键变更日志,增加内存开销。Doris 为主键 Union Read 设置尾部记录数上限;超过上限时,
auto调整读取路径,required报错。EXPLAIN显示是否使用 Union Read,以及湖端和日志端计划读取的范围;Query Profile 展示两侧耗时和行数。这些信息可用来判断成本来自历史扫描、日志尾部还是分层进度。
对反复执行且口径稳定的查询,可以按需要把结果写入 Doris 内表。
三、性能实测
为了直观地比较几种读法的开销,我们在单机上做了一组测试。
测试环境:一台 18 核、48 GB 内存的开发机:Doris 5.0(1 FE + 1 BE,BE 的 JVM 堆为默认的 2 GB),Fluss 1.0.0(1 个 CoordinatorServer、1 个 TabletServer),分层写入的 Paimon 湖仓放在同机的 MinIO 上。
测试表:3000 万个主键、13 列(每行约 210 字节)、16 个 Bucket 的主键表。
**每条查询预热 1 次后执行 5 次,取中位数。**单机环境下,Fluss 和湖的数据都经 Docker 端口转发,带宽有限,绝对值仅供参考,同一环境下不同读法之间的对比更有意义。
1. 主键表:纯 JNI 读 vs Union Read
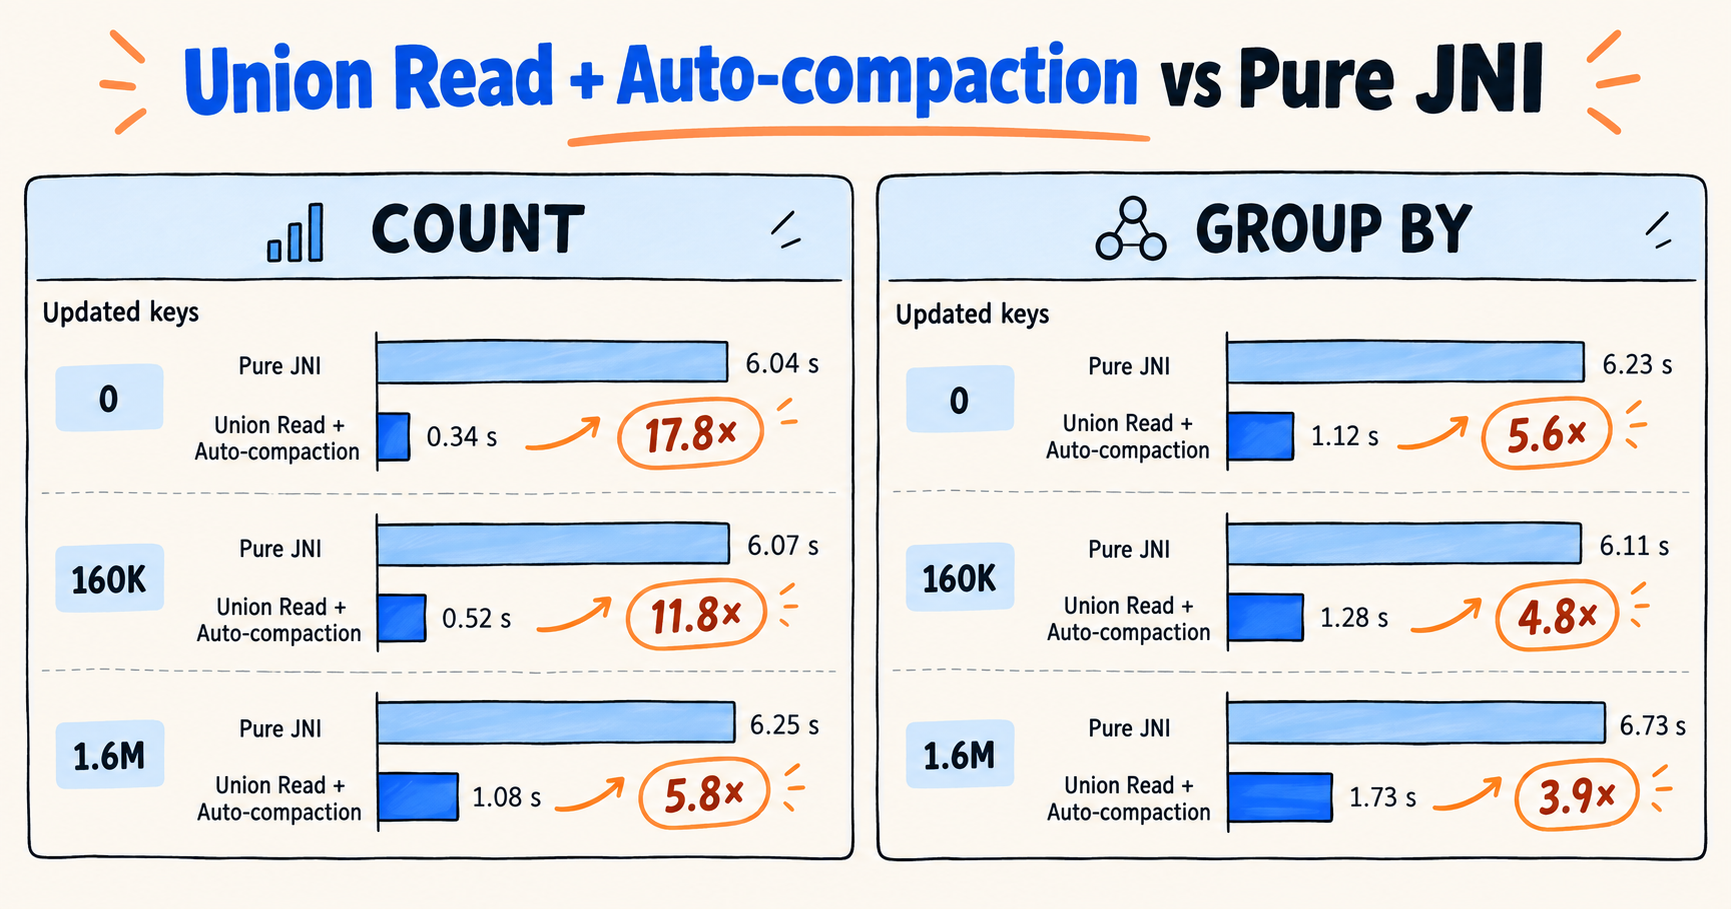
三种读法:
纯 JNI 读(
fluss.union_read.mode = 'disabled'):不读湖。每个 Bucket 把整份 KV 快照拷到 BE 本地,用 RocksDB 扫描,再合并快照之后的变更日志,还原每个主键的当前值。数据经 Fluss 的 Java SDK 读取,在 BE 中通过 JNI 调用。Union Read(湖表开启自动合并):以 Paimon 湖快照为基线,湖中的数据由 Doris 原生读取 Parquet;每个有尾部的 Bucket 用 JNI 从 Fluss 读一次尾部,按主键过滤湖中的旧行。湖表开启了
table.datalake.auto-compaction。Union Read(湖表未开启自动合并):同上,但湖中的文件互相重叠,要先经 Paimon 的 Java 读取器(JNI)合并才能读出。这是 Fluss 的默认配置。
表中第一列是湖快照之后更新过的主键数,也就是 Union Read 要从 Fluss 读取的尾部,对应每个 Bucket 0、1 万、10 万个主键。每格依次是计数(COUNT(*))、分组统计(按类别求计数、金额合计和折扣均值)、全表明细(SELECT *,不计结果回传客户端)的耗时,单位为秒。
| 湖快照之后更新过的主键 | 纯 JNI 读 | Union Read(湖表开启自动合并) | Union Read 快几倍(计数 / 分组统计) | Union Read(湖表未开启自动合并) |
|---|---|---|---|---|
| 0 | 6.04 / 6.23 / 8.07 | 0.34 / 1.12 / 9.27 | 17.8× / 5.6× | 1.06 / 2.08 / OOM |
| 16 万 | 6.07 / 6.11 / 6.98 | 0.52 / 1.28 / 9.65 | 11.8× / 4.8× | 1.06 / 1.97 / OOM |
| 160 万 | 6.25 / 6.73 / 7.84 | 1.08 / 1.73 / 10.80 | 5.8× / 3.9× | 1.40 / 2.83 / OOM |
CPU:全表明细时,纯 JNI 读的耗时比 Union Read 短 1–3 秒,但平均要占 9–10 个核(68–75 核·秒),Union Read 只占 1–2 个核(9–18 核·秒),CPU 时间是后者的 4–8 倍。本机的 KV 快照在本地磁盘上,而湖的数据要经端口转发,这对纯 JNI 读有利。
BE 磁盘占用:纯 JNI 读要先把每个 Bucket 的 KV 快照拷到 BE 的临时目录,才能用 RocksDB 打开,每条查询占用 2.9–4.3 GB(采样到的峰值),读完释放。Union Read 不读 KV 快照,不占用 BE 的本地磁盘。
OOM:湖表未开启自动合并时,合并读取会把多个文件的数据同时读进 BE 的 JVM 堆。全表明细默认用 16 个 scanner 并行读取,在默认 2 GB 的堆下内存不足,查询报
OutOfMemoryError。可以打开enable_jni_heap_admission避免(见下一节);更根本的做法是主键湖表开启table.datalake.auto-compaction。
2. BE JVM 内存控制
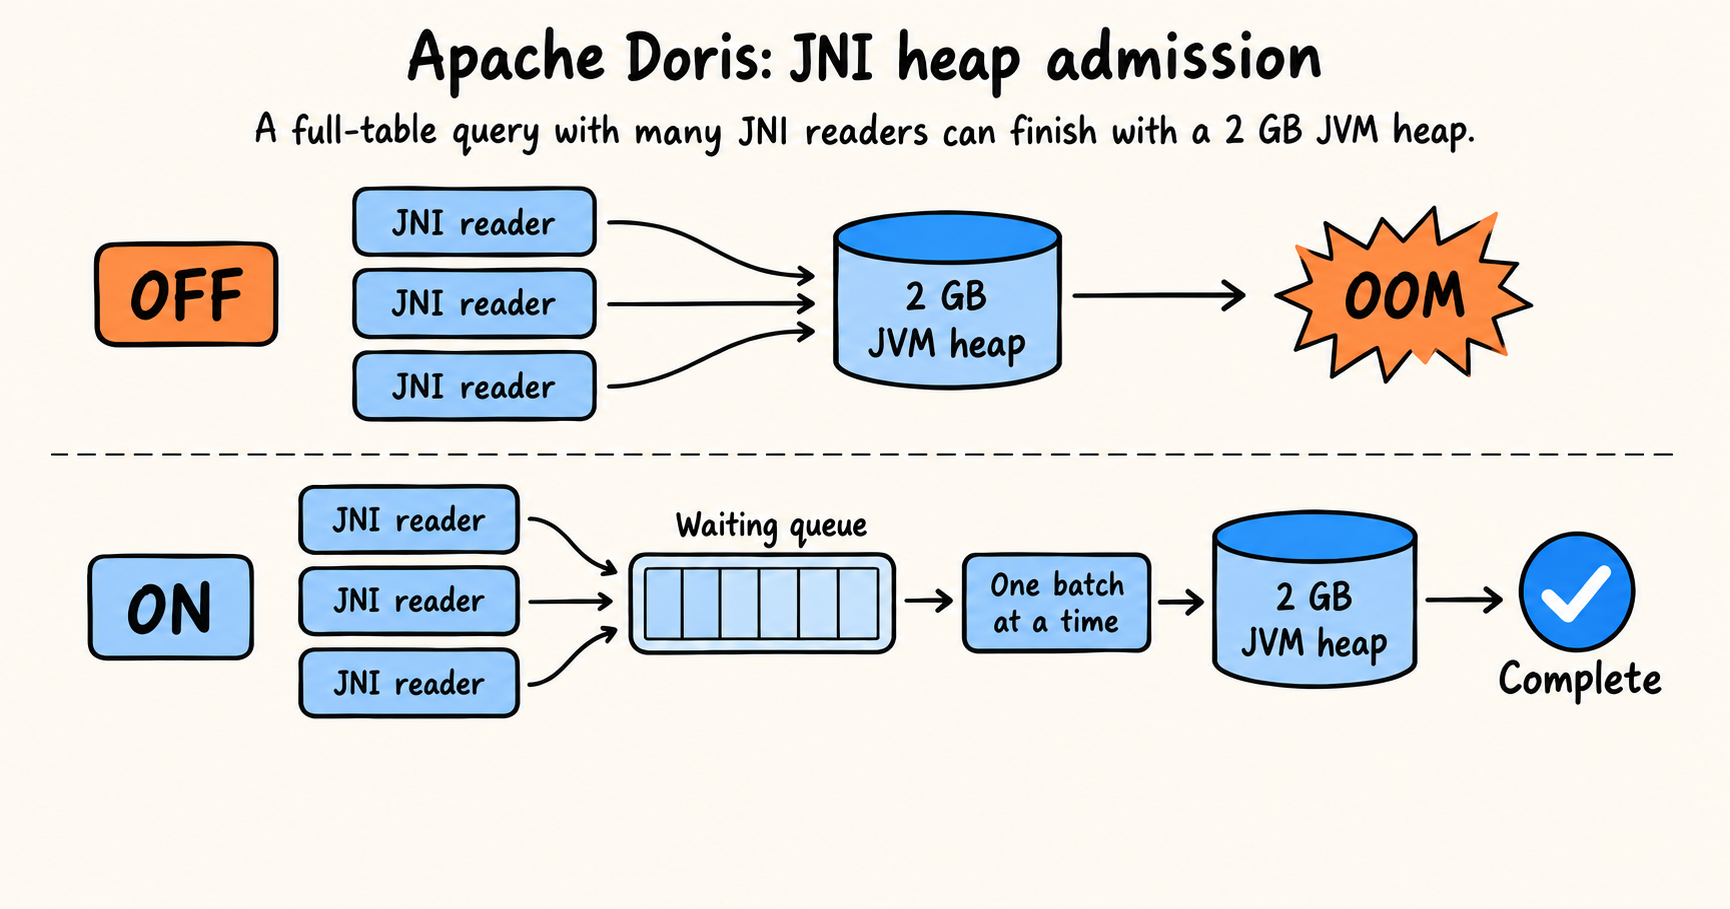
上表中湖表未开启自动合并时的全表明细,打开 enable_jni_heap_admission 前后的对比如下(BE 的 JVM 堆 2 GB):
| 湖快照之后更新过的主键 | 不开启 | 开启 enable_jni_heap_admission |
|---|---|---|
| 0 | OOM | 11.8s |
| 16 万 | OOM | 12.2s |
| 160 万 | OOM | 13.5s |
enable_jni_heap_admission 是 Doris 5.0 新增的会话变量,默认关闭。打开后,会大量占用 JVM 堆的读取(例如上面的合并读取)先申报预估的堆用量,BE 只在已放行读取的申报总量不超过 JVM 最大堆的一半时放行新的读取,其余的排队。读取分批使用堆,查询不再内存不足,代价是排队时间。
四、未来规划
Apache Doris 5.0 将以实验功能提供 Fluss Catalog,支持直接读取和分析 Fluss 数据。当前 Union Read 的湖端格式支持 Paimon,后续计划扩展至 Iceberg、Lance 等格式。同时,会针对历史读取、日志尾部合并和并发查询建立可复现的评估,再根据实际负载优化读取效率与资源使用。
另一项计划是逐步用 Fluss Rust SDK 承接日志和 KV 数据读取。目前 Doris 通过 Fluss Java SDK 读取这些数据,数据转换、内存占用及资源控制还有优化空间。Fluss 1.0 已提供 Rust SDK;接入 Doris 时,需要保持日志表、主键表和 Union Read 的读取语义,并用实际负载验证性能和资源收益。